
Gradio MCP სერვერების მასშტაბური განახლება: ვერსია 5.38.0-ის ახალი ფუნქციები
Gradio-მ გამოუშვა MCP სერვერების 5.38.0 ვერსია, რომელსაც ემატება მნიშვნელოვანი გაუმჯობესებები. ახლა შესაძლებელია ფაილების პირდაპირი ატვირთვა, AI ამოცანების პროგრესის რეალურ დროში მონიტორინგი, API-ების ავტომატური ინტეგრაცია OpenAPI-ის მეშვეობით, გაუმჯობესებული აუთენტიფიკაცია და ხელსაწყოების აღწერის მორგება. ეს განახლება დეველოპერებს მუშაობას უმარტივებს და ზრდის Gradio აპლიკაციების შესაძლებლობებს.
ღრმა გაძლიერებითი სწავლება: პროქსიმალური პოლიტიკის ოპტიმიზაცია (PPO)
ეს სტატია ღრმა გაძლიერებითი სწავლების კურსის ნაწილია და დეტალურად განიხილავს პროქსიმალური პოლიტიკის ოპტიმიზაციას (PPO). PPO არის არქიტექტურა, რომელიც აუმჯობესებს აგენტის ვარჯიშის სტაბილურობას პოლიტიკის გადაჭარბებული განახლებების თავიდან აცილებით. ჩვენ შევისწავლით, თუ როგორ იყენებს PPO მიმდინარე და ძველი პოლიტიკის თანაფარდობის კლიპინგს სტაბილური განახლებების უზრუნველსაყოფად. თეორიის შემდეგ, სტატია წარმოგიდგენთ PPO არქიტექტურის ნულიდან დაწერას PyTorch-ის გამოყენებით, მაგალითად CartPole-v1-სა და Lu
Google-მა CodeGemma - კოდზე ორიენტირებული დიდი ენობრივი მოდელები - გამოუშვა
Google-მა გამოუშვა CodeGemma, კოდზე სპეციალიზებული დიდი ენობრივი მოდელების (LLM) ოჯახი, რომელიც ეფუძნება 2B და 7B Gemma მოდელებს. ის ხელმისაწვდომია Hugging Face Hub-ზე სამ ვერსიად – CodeGemma 2B, CodeGemma 7B და CodeGemma 7B Instruct – და გამიზნულია კოდის შევსების, გენერაციისა და გაგების ამოცანებისთვის, ასევე მათემატიკური და ლოგიკური მსჯელობის გასაუმჯობესებლად. მოდელები გაწვრთნილია დამატებით 500 მილიარდ ტოკენზე და აჩვენებენ მაღალ წარმადობას კოდის შეფასების პოპულარულ ბენჩმარკებზე, როგორიცაა Human

FutureBench: ხელოვნური ინტელექტის შეფასების ახალი სტანდარტი მომავლის პროგნოზირებაში
არსებული AI ბენჩმარკები ძირითადად წარსულის ინფორმაციის ცოდნაზეა ორიენტირებული. FutureBench-ის ახალი მიდგომა ხელოვნური ინტელექტის შეფასებას მომავლის მოვლენების პროგნოზირებაზე ამახვილებს ყურადღებას. ეს კომპლექსური ამოცანა მოითხოვს დახვეწილ მსჯელობასა და სინთეზს, რაც რეალურ ღირებულებას ქმნის. ის გამორიცხავს მონაცემთა დაბინძურების რისკს და უზრუნველყოფს შედეგების ობიექტურ გადამოწმებას. FutureBench იყენებს რეალური სამყაროს მონაცემებსა და ახალ ამბებს საპროგნოზო ამოცანების შესაქმნელად, რაც AI აგენტებს ს

Sentence Transformers: სრული გზამკვლევი მოდელების ტრენინგისა და ოპტიმიზაციისთვის
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის მოდელების ვარჯიშისა და ოპტიმიზაციის შესახებ. განხილულია მოდელის არქიტექტურა, ემბედინგების შექმნა და მონაცემთა მომზადების გადამწყვეტი როლი, მათ შორის სხვადასხვა მონაცემთა ნაკრების ფორმატები, როგორებიცაა მსგავსება, პოზიტიური წყვილები, კლასიფიკაცია და ტრიპლეტები. ასევე აღწერილია მონაცემების მოდელისთვის გასაგებ ფორმატში კონვერტირების პროცესი.
Google Cloud-ი და Hugging Face-ი გენერაციული AI მოდელების განთავსებას ამარტივებენ
Google Cloud-მა და Hugging Face-მა გამოუშვეს ახალი ფუნქცია „Deploy on Google Cloud“, რომელიც დეველოპერებს საშუალებას აძლევს, შექმნან საწარმოო მზადყოფნის გენერაციული ხელოვნური ინტელექტის (AI) აპლიკაციები ინფრასტრუქტურის მართვის გარეშე, პირდაპირ მათ უსაფრთხო Google Cloud გარემოში. ეს გაფართოება Google-ის მომხმარებლებისთვის ღია გენერაციული AI მოდელებზე წვდომასა და მათ განთავსებას ამარტივებს, Vertex AI-სა და GKE-ზე 1-კლიკით განთავსების გამოცდილებას სთავაზობს.

Consilium: ხელოვნური ინტელექტის მოდელების თანამშრომლობა კონსენსუსისთვის
Consilium წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დიდ ენობრივ მოდელებს (LLM) აძლევს საშუალებას, მიაღწიონ კონსენსუსს დისკუსიის გზით. ჰაკათონის ფარგლებში შექმნილი პროექტი აერთიანებს Gradio ინტერფეისს და MCP სერვერს, რაც LLM-ებს საშუალებას აძლევს ითანამშრომლონ, შექმნან დასაბუთებული პასუხები და მიიღონ გადაწყვეტილებები. პლატფორმა ვიზუალურად წარმოადგენს მრგვალ მაგიდას, სადაც მოდელები დისკუსიას აწარმოებენ, ხოლო Microsoft-ის AI Diagnostic Orchestrator-ის მიერ მიღწეული შედეგები ადასტურებს, რომ მრავალი
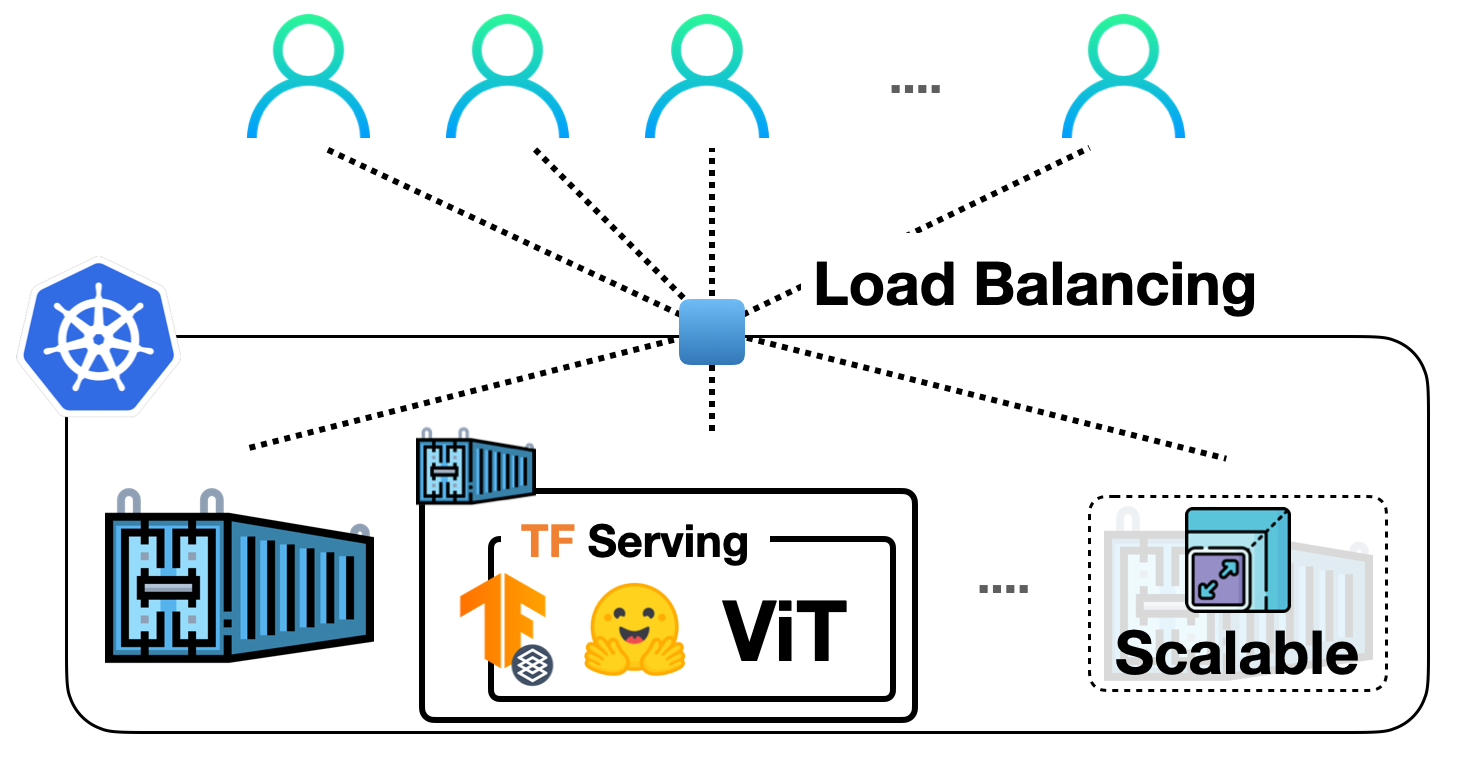
ML მოდელების მასშტაბირება Docker-ით და Kubernetes-ით: ლოკალურიდან სრულმასშტაბიან დეპლოიმენტამდე
ეს პოსტი გაწვდით დეტალურ სახელმძღვანელოს, თუ როგორ გადახვიდეთ მანქანური სწავლების მოდელების ლოკალური განთავსებიდან მასშტაბირებად, რეალურ პროექტებში გამოსაყენებელ სისტემებზე Docker-ისა და Kubernetes-ის გამოყენებით. სტატია აღწერს აპლიკაციის ლოგიკის კონტეინერიზაციას, Docker-ის კონტეინერების განთავსებას Kubernetes კლასტერზე (კერძოდ Google Kubernetes Engine-ზე - GKE), TensorFlow Serving-ის გამოყენებას მოდელების მომსახურებისთვის, მორგებული Docker გამოსახულებების შექმნას და მათ Google Container Registr
ხედვითი ენის მოდელები: შესაძლებლობები, შეფასება და სწავლება
ხედვითი ენის მოდელები (VLM) არის ხელოვნური ინტელექტის მოდელები, რომლებსაც შეუძლიათ ერთდროულად ისწავლონ გამოსახულებებიდან და ტექსტებიდან, რაც მათ საშუალებას აძლევს შეასრულონ მრავალი დავალება, როგორიცაა ვიზუალურ კითხვებზე პასუხის გაცემა და გამოსახულების აღწერა. ისინი გენერაციული მოდელებია, რომლებიც იღებენ გამოსახულებისა და ტექსტის შეტანას და წარმოქმნიან ტექსტურ გამოსავალს. ამ მოდელებს გააჩნიათ კარგი „ნულოვანი-კადრის“ (zero-shot) შესაძლებლობები და გამოიყენება გამოსახულებებზე საუბრისთვის, დოკუმენტებ

ხელოვნური ინტელექტი უჯრედის მოდელირებაში: გენის გაჩუმების ეფექტის პროგნოზირება CRISPR-ით
„ვირტუალური უჯრედის გამოწვევა“ მიზნად ისახავს ისეთი ხელოვნური ინტელექტის მოდელის შექმნას, რომელიც შეძლებს CRISPR-ის გამოყენებით გენის გაჩუმების შედეგად უჯრედზე მიღებული ეფექტების პროგნოზირებას, ფიზიკური, ძვირადღღირებული ექსპერიმენტების საჭიროების გარეშე. გამოწვევისთვის Arc-მა შეაგროვა 300 ათასი ერთუჯრედოვანი რნმ სეკვენირების პროფილის მონაცემთა ნაკრები. ამ პროცესში მნიშვნელოვანი სირთულეებია უჯრედის მდგომარეობის გაზომვის შეუძლებლობა ცვლილებამდე და მის შემდეგ, რაც მოითხოვს საკონტროლო უჯრედების გამო
AI-ის როლი გენის გაჩუმების პროგნოზირებაში: ვირტუალური უჯრედის გამოწვევა
თანამედროვე კვლევები მიზნად ისახავს ხელოვნური ინტელექტის (AI) მოდელის შექმნას, რომელიც CRISPR-ის გამოყენებით გენის გაჩუმების უჯრედზე ზემოქმედებას იწინასწარმეტყველებს. „ვირტუალური უჯრედის გამოწვევა“ ცდილობს გადალახოს ფიზიკური ექსპერიმენტების სირთულეები და მაღალი ღირებულება, რაც საშუალებას მისცემს ათასობით წამლის კანდიდატის ტესტირებას ვირტუალურ გარემოში. Arc-ის მიერ შეგროვებული 300 ათასი ერთუჯრედოვანი რნმ-ის სექვენირების პროფილის მონაცემთა ნაკრები გამოიყენება ნერვული ქსელების სავარჯიშოდ. სტატია ას
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit
Hugging Face-ის ტრანსფორმატორები TensorFlow-ის ინჟინრებისთვის: გზამკვლევი
სტატია განიხილავს PyTorch-ის ინჟინრების მიერ TensorFlow-თან მიდგომის ხშირ შეცდომას, კერძოდ, Keras-ის მაღალი დონის API-ის უგულებელყოფას. ხაზგასმულია, რომ Keras-ის გამოყენება TensorFlow-სთან ოპტიმალურია. შემდეგ წარმოდგენილია Hugging Face-ის ტრანსფორმატორები, როგორც ძლიერი ინსტრუმენტები, რომლებიც TensorFlow-ის ინჟინრებს საშუალებას აძლევს, გამოიყენონ უახლესი მოდელები ნაცნობი Keras API-ის მეშვეობით. დეტალურად არის ახსნილი ტრანსფერული სწავლის (transfer learning) კონცეფცია, როგორც ML პრობლემების გადაჭრ
Idefics2: Hugging Face-ის ახალი, 10-ჯერ მცირე ზომის მულტიმოდალური AI მოდელი მნიშვნელოვანი გაუმჯობესებებით
Idefics2, Hugging Face-ის ახალი მულტიმოდალური AI მოდელი, მისი წინამორბედისგან განსხვავებით 10-ჯერ მცირე ზომისაა და მნიშვნელოვნად გაუმჯობესებულ შესაძლებლობებს გვთავაზობს. ის გაწვრთნილია მრავალფეროვან მონაცემთა ნაკრებებზე, მათ შორის ახლად გამოშვებულ „The Cauldron“-ზე, რომელიც მრავალმხრივი საუბრებისთვისაა განკუთვნილი. მოდელი, რომელიც აგებულია Mistral-7B-v0.1-სა და siglip-so400m-patch14-384-ზე, უკვე ხელმისაწვდომია Hugging Face Hub-ზე Apache-2.0 ლიცენზიით.

NVIDIA NIM ამარტივებს ხელოვნური ინტელექტის მოდელების, მათ შორის LLM-ების განთავსებას
NVIDIA NIM ინფერენციის მიკროსერვისები მომხმარებლებსა და პარტნიორებს საშუალებას აძლევს, გამარტივებული მიდგომით, სწრაფად და საიმედოდ განათავსონ ხელოვნური ინტელექტის უახლესი მოდელები, განსაკუთრებით დიდი ენობრივი მოდელები (LLM). ის მხარს უჭერს 100 000-ზე მეტ LLM-ს Hugging Face-ზე, მუშაობს ერთ Docker კონტეინერში და უზრუნველყოფს ავტომატურ ოპტიმიზაციას კონფიგურაციის გარეშე. ეს სისტემა მიზნად ისახავს AI ინოვაციების დაჩქარებას NVIDIA-ს აჩქარებულ ინფრასტრუქტურაზე, რაც დეველოპერებსა და საწარმოებს ეხმარება
Hugging Face-მა ახალი ბიბლიოთეკა Skops წარადგინა: scikit-learn მოდელების ჰოსტინგი და თანამშრომლობა გაუმჯობესდა
Hugging Face-მა წარმოადგინა Skops, ახალი ბიბლიოთეკა, რომელიც შექმნილია scikit-learn მოდელების Hugging Face Hub-ზე განთავსების პროცესის გასამარტივებლად. Skops უზრუნველყოფს მოდელების უსაფრთხო ჰოსტინგს, დოკუმენტაციას მოდელის ბარათების მეშვეობით და გაუმჯობესებულ თანამშრომლობას, რითაც ღია კოდის მანქანური სწავლების პროექტებისთვის რეპროდუცირებადობა და ახსნადობა უფრო ხელმისაწვდომი ხდება.

Ryght Preview-ის ოფიციალური გაშვება: ხელოვნური ინტელექტი ჯანდაცვისა და სიცოცხლის მეცნიერებებისთვის
კომპანია Ryght-ი ოფიციალურად უშვებს Ryght Preview-ს, გენერაციული ხელოვნური ინტელექტის პლატფორმას, რომელიც შექმნილია ჯანდაცვისა და სიცოცხლის მეცნიერებების სექტორისთვის. პლატფორმა მიზნად ისახავს ამ სფეროებში მონაცემთა მოძველებული ანალიზის პრობლემის გადაჭრას, რაც დიდ გუნდებს მოითხოვს. Ryght უზრუნველყოფს სწრაფ და უსაფრთხო ანალიტიკურ მონაცემებს წამლის შექმნის, კლინიკური კვლევებისა და კომერციული საქმიანობის დასაჩქარებლად. კომპანია პარტნიორობს Hugging Face-თან ტექნიკური მხარდაჭერისთვის, რათა მუდმივად ი

Flux.1-Dev მოდელის ინფერენციის ოპტიმიზაცია LoRA-ს გამოყენებით: 2.3x-მდე სიჩქარის ზრდა
ეს პოსტი დეტალურად განიხილავს Flux.1-Dev ტექსტიდან გამოსახულების გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაციას, განსაკუთრებით LoRA-ების გამოყენებისას. შემოთავაზებულია "ცხელი გაცვლის" (hotswapping) ტექნიკა ხელახალი კომპილაციის თავიდან ასაცილებლად, FP8 კვანტიზაციის უპირატესობები, და სტრატეგიები სამომხმარებლო GPU-ებისთვის, როგორიცაა RTX 4090, CPU-ზე გადმოტვირთვით და T5 ტექსტური ენკოდერის კვანტიზაციით, რაც უზრუნველყოფს 2.3-ჯერადი სიჩქარის ზრდას.
Flux.1-Dev-ის ოპტიმიზაცია LoRAs-ით: ინფერენციის სიჩქარისა და მეხსიერების გაუმჯობესება
ამ პოსტში განხილულია Flux.1-Dev ტექსტი-გამოსახულებაზე გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაცია LoRA ადაპტერების გამოყენებისას. LoRAs-ის ფართო გამოყენებისა და მრავალფეროვნების გათვალისწინებით, რთულია მათი ცხელად ცვლა (hotswap) მოდელის გადაკომპილაციის გარეშე, რაც სიჩქარის დაკარგვას იწვევს. სტატია გვთავაზობს ოპტიმიზაციის რეცეპტს, რომელიც მოიცავს `hotswap=True` ფუნქციის გამოყენებას, `torch.compile`-ს, FP8 კვანტიზაციას, CPU-ზე გადატვირთვას (CPU offloading) და T5 ტექსტური ენკოდერის კვანტიზა
ენის დიდი მოდელების ოპტიმიზაცია: Hugging Face-ის LLM.int8() ინტეგრაცია
ენის დიდი მოდელები (LLM) მუდმივად იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა, BigScience-თან თანამშრომლობით, წარმოადგინა LLM.int8() ინტეგრაცია, რომელიც საშუალებას აძლევს ამ მასშტაბურ მოდელებს იმუშაონ ნაკლებ GPU-ზე, მეხსიერების მოხმარების 2-ჯერ შემცირებით, პროგნოზირების სიზუსტის შენარჩუნებით. სტატია დეტალურად განიხილავს ამ ტექნოლოგიას და სხვადასხვა მცოცავწერტილიანი მონაცემთა ტიპებს, რომლებიც მოდელის ზომასა და მუშაობაზე ახდენენ გავლენას.
LLM.int8(): როგორ გავხადოთ გიგანტური ენის მოდელები უფრო ხელმისაწვდომი
თანამედროვე ენის მოდელები სულ უფრო იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა და BigScience-მა წარმოადგინეს LLM.int8() ინტეგრაცია, რომელიც მოდელების პროგნოზირების ხარისხის შენარჩუნებით ამცირებს მათ მეხსიერების მოხმარებას 2-ჯერ. სტატია დეტალურად განმარტავს ამ კვანტიზაციის ტექნოლოგიას, მონაცემთა სხვადასხვა ტიპის სიზუსტესა და პარტნიორობის სამომავლო მიზნებს.
Zama-ს Concrete ML: კონფიდენციალურობის დაცვა მანქანურ სწავლებაში Hugging Face-ზე
თვრამეტი თვის წინ Zama-მ შექმნა Concrete ML – მანქანური სწავლების ფრეიმვორკი, რომელიც უზრუნველყოფს მონაცემთა კონფიდენციალურობას სრულად ჰომომორფული დაშიფვრის (FHE) გამოყენებით. ეს კრიპტოგრაფიული ინსტრუმენტი შესაძლებელს ხდის პირდაპირ გამოთვლებს დაშიფრულ მონაცემებზე პირადი გასაღების ცოდნის გარეშე. დღეიდან, Zama-ს წინასწარ კომპილირებული FHE-თან თავსებადი მოდელები ხელმისაწვდომია Hugging Face Endpoints-ზე, რაც მომხმარებლებს საშუალებას აძლევს, ერთი დაწკაპუნებით განათავსონ და გამოიყენონ კონფიდენციალურობ

TimeScope: ახალი ბენჩმარკი ხელოვნური ინტელექტის გრძელი ვიდეოების აღქმის სიღრმის შესამოწმებლად
TimeScope არის ახალი ღია კოდის ბენჩმარკი, რომელიც შექმნილია იმის შესაფასებლად, თუ რამდენად კარგად ესმით ვიზუალურ-ლინგვისტურ მოდელებს გრძელი ვიდეოები. ის ვიდეოებში (1 წუთიდან 8 საათამდე) მოკლე „ნემსის“ კლიპების ჩართვით აფასებს მოდელების უნარს არა მხოლოდ ინფორმაციის მოძიებაში, არამედ მის სინთეზში, ლოკალიზაციასა და წვრილმარცვლოვან მოძრაობის ანალიზში, რითაც არსებულ ტესტებში არსებულ ხარვეზებს ავსებს და AI-ს გრძელი ვიდეოების გაგების ნამდვილ შესაძლებლობებს ავლენს.

Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.