
Reachy Mini: ხელოვნური ინტელექტის რობოტი კოდირებისა და ექსპერიმენტებისთვის
წარმოგიდგენთ Reachy Mini-ს, ექსპრესიულ, ღია კოდის რობოტს, რომელიც შექმნილია ადამიანისა და რობოტის ურთიერთქმედებისთვის, კრეატიული კოდირებისა და ხელოვნური ინტელექტის ექსპერიმენტებისთვის. $299-დან ხელმისაწვდომი და Python-ზე სრულად პროგრამირებადი (მალე JavaScript-სა და Scratch-ზეც), ის თქვენი კარიბჭეა რობოტიკულ ხელოვნურ ინტელექტში. ეს სახალისო, კონფიგურირებადი სისტემა მზადაა გახდეს თქვენი შემდეგი კოდირების პროექტის ნაწილი, რაც დეველოპერებს, მკვლევარებს, მასწავლებლებს და ენთუზიასტებს საშუალებას აძლევ
აქტორ-კრიტიკოსის მეთოდები ღრმა განმტკიცებით სწავლაში
სტატია განიხილავს აქტორ-კრიტიკოსის მეთოდებს, ჰიბრიდულ მიდგომას ღრმა განმტკიცებით სწავლაში, რომელიც აერთიანებს პოლიტიკაზე დაფუძნებულ და ღირებულებაზე დაფუძნებულ მეთოდებს. ეს მიდგომა მიზნად ისახავს ისეთი პოლიტიკის გრადიენტული ალგორითმების, როგორიცაა Reinforce, მაღალი დისპერსიის პრობლემის გადაჭრას, რაც ხელს უწყობს სწავლის სტაბილიზაციასა და დაჩქარებას. სტატია მოიცავს Advantage Actor Critic (A2C) მეთოდს და მის გამოყენებას რობოტულ გარემოში Stable-Baselines3-ის მეშვეობით.
Hugging Face: მანქანური სწავლის სამყარო არატექნიკური მომხმარებლებისთვის
ეს გზამკვლევი მიზნად ისახავს მანქანური სწავლის (ML) ფუნდამენტური პრინციპების ხელმისაწვდომად ახსნას არატექნიკური მომხმარებლებისთვის, პითონის ცოდნის საჭიროების გარეშე. იგი დეტალურად განიხილავს Hugging Face-ის ეკოსისტემას, მათ შორის Transformers-ის ბიბლიოთეკას, Hugging Face Hub-ს და Spaces-ს, რომლებიც აადვილებს ML მოდელების გამოყენებასა და განლაგებას. ასევე განმარტებულია LLM-ებისთვის საჭირო GPU-ების დაქირავების პროცესი Hugging Face-ის მეშვეობით, Docker-ის შაბლონების მნიშვნელობა და ძირითადი პროგრამი

Hugging Face-ის MCP სერვერის შექმნა: AI ასისტენტების დაკავშირების გამოცდილება და პროტოკოლის ევოლუცია
Hugging Face-ის გუნდი დეტალურად აღწერს Model Context Protocol (MCP) სერვერის შექმნის პროცესს, რომელიც ხელოვნური ინტელექტის ასისტენტებს გარე სამყაროსთან აკავშირებს. სტატია აანალიზებს პროტოკოლის სწრაფ ევოლუციას, ტრანსპორტის სხვადასხვა ვარიანტს (STDIO, HTTP SSE-ით, ნაკადოვანი HTTP) და იმ ტექნიკურ გადაწყვეტილებებს, რომლებიც Hugging Face-მა მიიღო ოპტიმალური, დინამიური და ადვილად ხელმისაწვდომი hf.co/mcp სერვერის შესაქმნელად. ყურადღება ექცევა უსტატუსო, პირდაპირი პასუხის კონფიგურაციის არჩევანს წარმოების
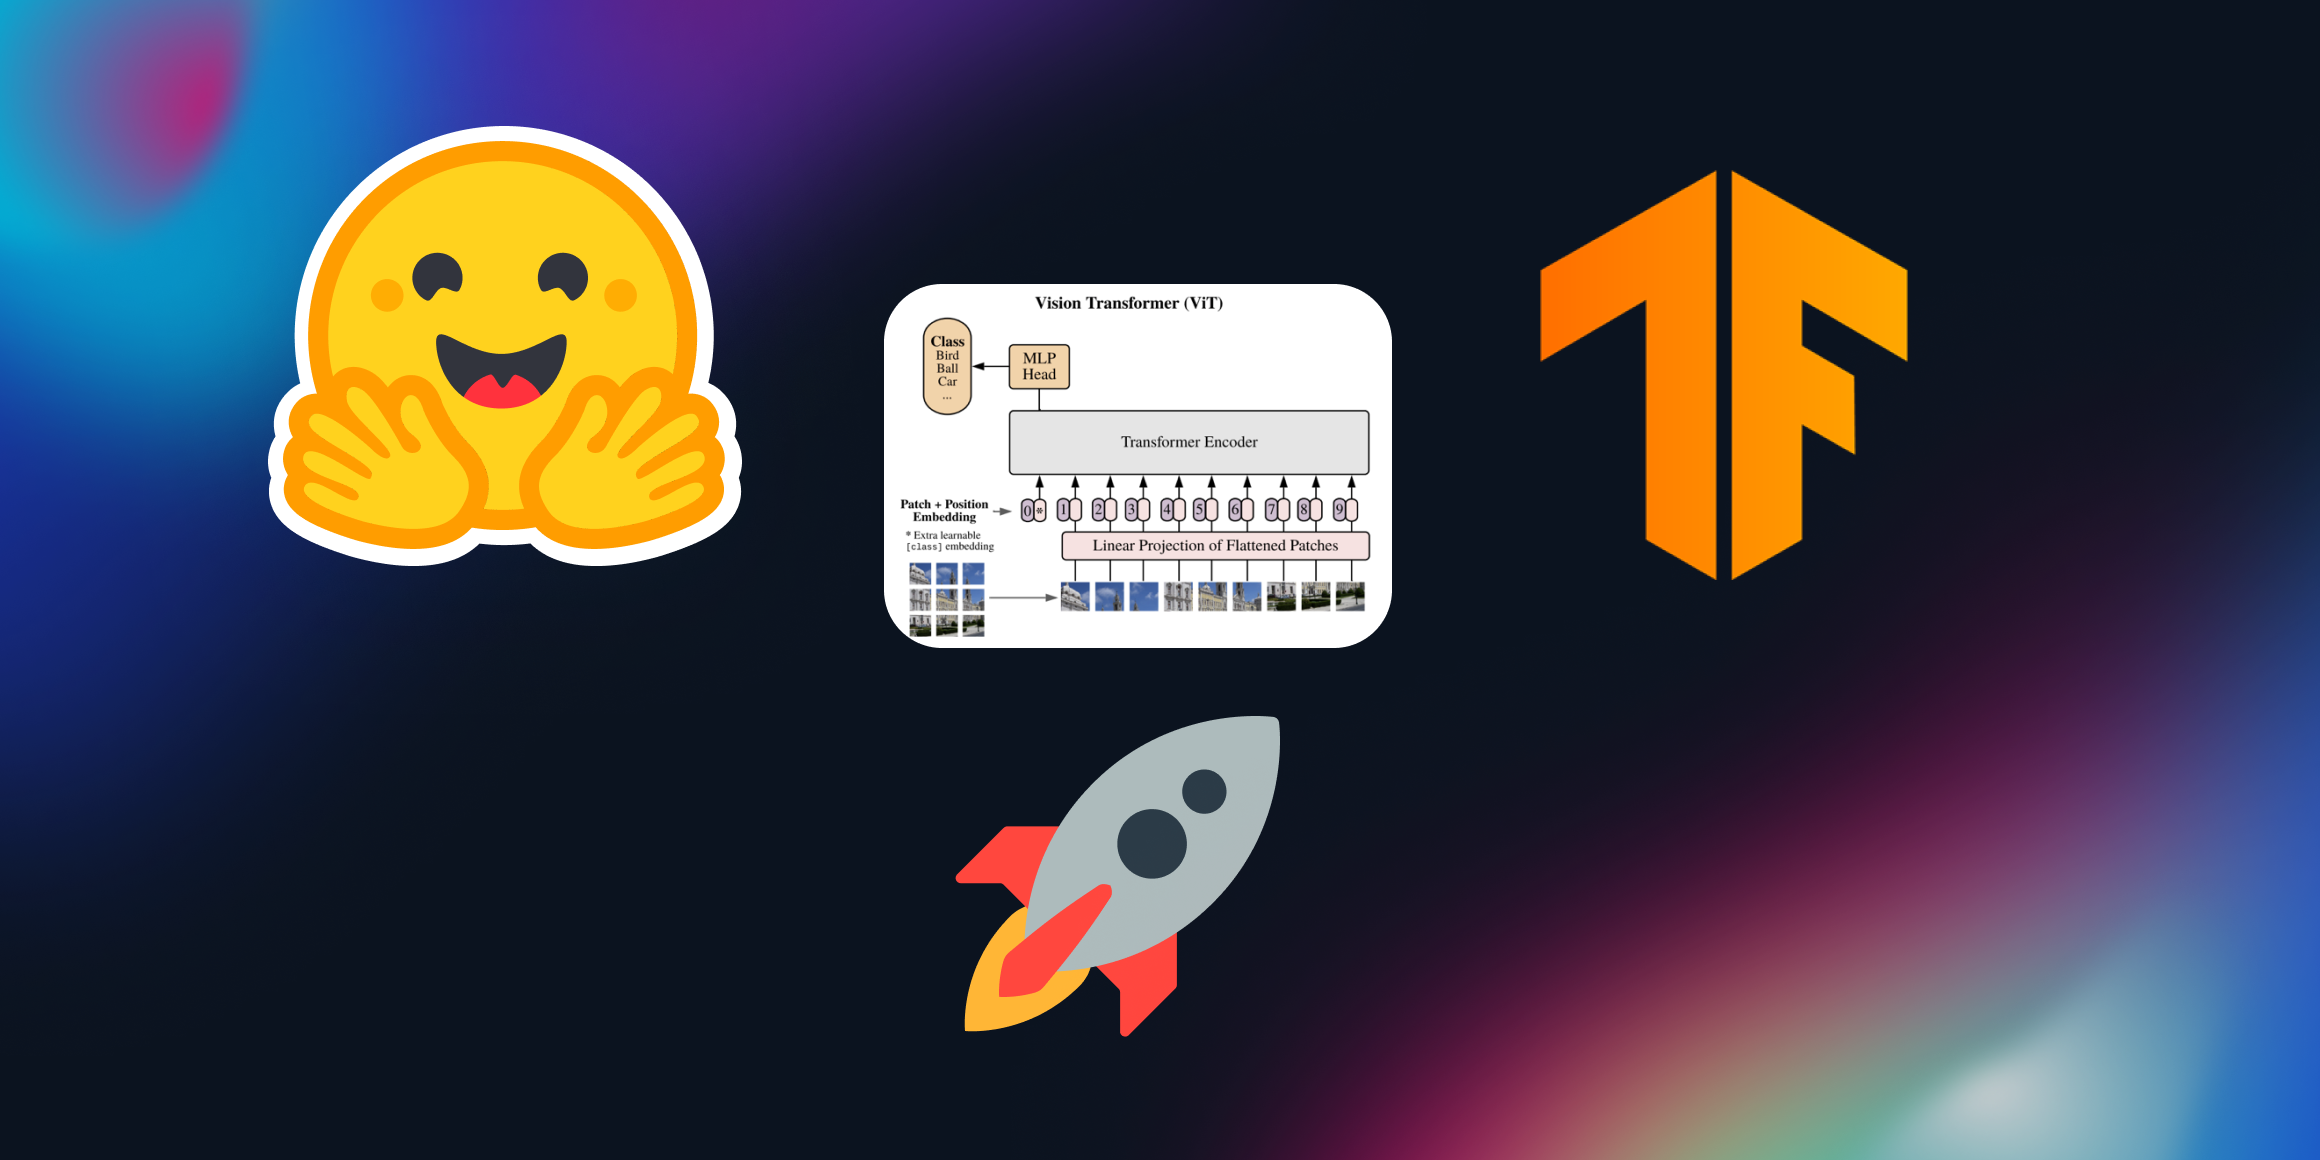
Vision Transformer მოდელის ლოკალურად განთავსება TensorFlow Serving-ის გამოყენებით
ეს პოსტი დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Vision Transformer (ViT) მოდელის (გამოსახულების კლასიფიკაციისთვის) ლოკალურად განთავსება TensorFlow Serving-ის (TF Serving) მეშვეობით. ის განმარტავს მოდელის შენახვას SavedModel ფორმატში, წინასწარი და შემდგომი დამუშავების ნაბიჯების ინტეგრირებას გამოთვლით გრაფში და საბოლოოდ, მოდელის გაშვებას REST ან gRPC ენდპოინტებად TF Serving-ის გამოყენებით, რითაც შემცირდება დეველოპერების კოგნიტური დატვირთვა და გაუმჯობესდება სისტემის ეფექტურობა.
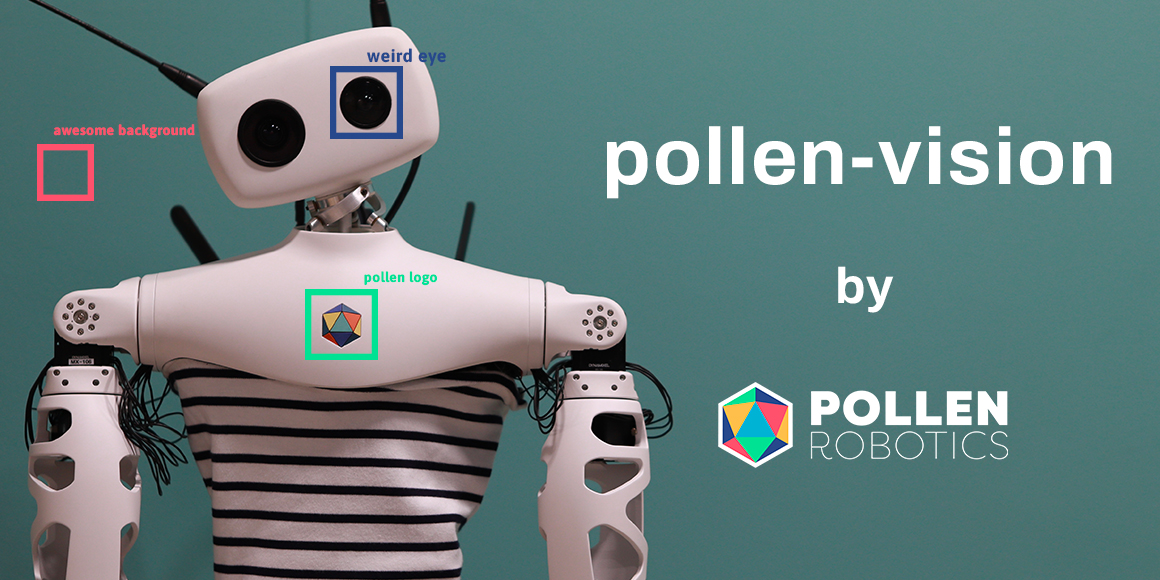
Pollen-vision: ღია კოდის ბიბლიოთეკა, რომელიც რობოტებს უცნობი ობიექტების ავტონომიურ დაჭერაში ეხმარება
წარდგენილია Pollen-vision, ახალი ღია კოდის ბიბლიოთეკა, რომელიც რობოტებს გარემოს ვიზუალური აღქმის საფუძველზე გაგებაში და 3D ობიექტების დეტექციაში ეხმარება. მისი მთავარი მიზანია რობოტების ავტონომიური ფუნქციონირება უცნობი ობიექტების წინასწარი წვრთნის გარეშე დაჭერის მიზნით.

ScreenEnv: დესკტოპის ავტომატიზაციისა და AI აგენტების რევოლუცია Docker კონტეინერებში
ScreenEnv წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დესკტოპის ამოცანების ავტომატიზაციას, GUI აპლიკაციების ტესტირებასა და AI აგენტების შექმნას ამარტივებს. ის გთავაზობთ სანდბოქსირებულ დესკტოპ გარემოს Docker კონტეინერში, რაც უზრუნველყოფს სრულ კონტროლს ვირტუალურ სესიაზე, კომპლექსური VM-ების საჭიროების გარეშე. პლატფორმა ადაპტირდება არსებულ ინფრასტრუქტურასთან და მომავალში გეგმავს ქროს-პლატფორმულ მხარდაჭერას Android-ის, macOS-ისა და Windows-ისთვის.

TensorFlow-ში ტექსტის გენერაციის დაჩქარება XLA-ს მეშვეობით
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (LLM) განვითარებას და მათ ტექსტის გენერაციის შესაძლებლობებს. დეტალურად არის განხილული Hugging Face-ის `transformers` ბიბლიოთეკაში ტექსტის გენერაციის საფუძვლები TensorFlow-ს გამოყენებით, მათ შორის დეტერმინისტული და სტოქასტური მეთოდები, სემპლინგის კონტროლი და Beam Search. მთავარი აქცენტი გაკეთებულია TensorFlow-ში ტექსტის გენერაციის ოპტიმიზაციაზე XLA (Accelerated Linear Algebra) კომპაილერის მეშვეობით, რომელიც მნიშვნელოვნად აჩქარებს პროცესს და ამცირებს დაყო
Cloudflare Workers AI და Hugging Face-ის ინტეგრაცია: ხელმისაწვდომი გენერაციული AI დეველოპერებისთვის
Cloudflare Workers AI-ზე განთავსება დეველოპერებს საშუალებას აძლევს შექმნან მძლავრი გენერაციული AI აპლიკაციები GPU ინფრასტრუქტურისა და სერვერების მართვის გარეშე, ძალიან დაბალი საოპერაციო ხარჯებით. ეს ინტეგრაცია, რომელიც აფართოებს Cloudflare-ისა და Hugging Face-ის სტრატეგიულ პარტნიორობას, გვთავაზობს სერვერების გარეშე (serverless) წვდომას პოპულარულ Hugging Face მოდელებზე, მოთხოვნის მიხედვით გადახდის (pay-per-request) მოდელით, რითაც წყდება GPU-ს სიმცირისა და ფიქსირებული ხარჯების პრობლემა.

ასინქრონული ინფერენცია რობოტებში: 2-ჯერ დაჩქარება და გაუმჯობესებული რეაგირება
რობოტიკის სფეროში დანერგილი ასინქრონული ინფერენცია მიზნად ისახავს რობოტების დავალების შესრულების სიჩქარისა და რეაგირების გაუმჯობესებას. თანმიმდევრული ინფერენციისგან განსხვავებით, რომელიც შეფერხებებს იწვევს, ეს ახალი მიდგომა მოქმედების პროგნოზირებასა და აღსრულებას ერთმანეთისგან აცალკევებს. SmolVLA მოდელში დანერგვით, ამ სისტემამ აჩვენა დავალების დასრულების დროის დაახლოებით 2-ჯერ შემცირება და რობოტი აღარასდროს ელოდება ინფერენციას, რაც უზრუნველყოფილია მაღალეფექტურ gRPC-ზე დაფუძნებული კომუნიკაციით.
Hugging Face Datasets: ახალი შესაძლებლობები აუდიო და გამოსახულების მონაცემებთან მუშაობისთვის
Hugging Face Datasets ბიბლიოთეკა აფართოებს თავის მხარდაჭერას ტექსტური მონაცემთა ნაკრებების მიღმა, რათა მოიცვას აუდიო და გამოსახულების ფორმატები. განახლებები მოიცავს ახალ ინსტრუმენტებს, როგორიცაა ImageFolder გამოსახულების მონაცემთა ნაკრებების მარტივად ჩატვირთვისა და მართვისთვის, to_tf_dataset ფუნქცია TensorFlow-თან ინტეგრაციის გასამარტივებლად და გაუმჯობესებულ დოკუმენტაციას სხვადასხვა მონაცემთა მოდალობასთან მუშაობისთვის. ეს ცვლილებები მიზნად ისახავს დეველოპერებისთვის მოდელების გაწვრთნისა და აპლიკა

SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
SetFit-ის ინფერენციის 7.8-ჯერ დაჩქარება Intel CPU-ებზე Optimum Intel-ის გამოყენებით
SetFit, ხელოვნური ინტელექტის მოდელი, რომელიც ცნობილია მცირე მარკირებული მონაცემებით მაღალი სიზუსტის მიღწევით, ახლა შესაძლებელია Intel CPU-ებზე 7.8-ჯერ უფრო სწრაფად ამუშავდეს. ეს მიიღწევა 🤗 Optimum Intel-ის ბიბლიოთეკის გამოყენებით და პოსტ-ტრენინგული კვანტიზაციით, რაც SetFit-ის გადაწყვეტილებების წარმოებაში დანერგვას საგრძნობლად აადვილებს და გამტარუნარიანობას ზრდის.
Numina-სა და Kimi-ის გუნდი: Kimina-Prover-72B-ის გამოშვება
Numina-მ და Kimi-მ წარმოადგინეს Kimina-Prover-72B, უახლესი ხელოვნური ინტელექტის მოდელი თეორემების დამტკიცებისთვის, რომელიც გაწვრთნილია Kimi k1.5 RL სისტემით და დაფუძნებულია Qwen2.5-72B-ზე. მოდელის ძირითადი ინოვაციებია ტესტირების დროს განმტკიცებითი სწავლის ძიება (TTRL) რთული, მრავალსაფეხურიანი მტკიცებულებებისთვის ლემების გამოყენებით და შეცდომების გამოსწორების შესაძლებლობა, რაც მნიშვნელოვნად ზრდის ეფექტურობას. Kimina-Prover-მა მიაღწია 92.2%-იან უპრეცედენტო წარმატებას miniF2F ბენჩმარკზე, რამაც მას
Hugging Face მხარს უჭერს NAIRR-ის საგზაო რუკას ხელმისაწვდომი ხელოვნური ინტელექტისთვის
Hugging Face-მა უპასუხა თეთრი სახლის მოთხოვნას ეროვნული ხელოვნური ინტელექტის კვლევის რესურსის (NAIRR) საგზაო რუკის შესახებ, ხაზგასმით აღნიშნა ხელმისაწვდომი და პასუხისმგებლობითი ხელოვნური ინტელექტის მნიშვნელობა. მათ წარმოადგინეს ძირითადი რეკომენდაციები, მათ შორის, მრავალფეროვანი ექსპერტების დანიშვნა, დოკუმენტაციის სტანდარტების დადგენა და ბოროტად გამოყენების მონიტორინგი.
AI-ის რევოლუცია მონაცემებთან ურთიერთობაში: DuckDB-NSQL-7B და ტექსტიდან SQL-ზე გადასვლა
ხელოვნური ინტელექტის (AI) და დიდი ენობრივი მოდელების (LLM) განვითარება რევოლუციას ახდენს მონაცემთა ანალიზში. ტრადიციულად, SQL ქუერების შექმნა მოითხოვდა სპეციალიზებულ ცოდნას, რაც ხელმისაწვდომობის ხარვეზს ქმნიდა. MotherDuck-მა და Numbers Station-მა წარმოადგინეს DuckDB-NSQL-7B, LLM, რომელიც სპეციალურად DuckDB SQL-ისთვისაა შექმნილი. ეს მოდელი მომხმარებლებს საშუალებას აძლევს, ბუნებრივი ენით ჩამოაყალიბონ მონაცემთა მოთხოვნები, რომლებსაც მოდელი ავტომატურად თარგმნის SQL ბრძანებებში. სტატიაში დეტალურად არ
DuckDB-NSQL-7B: ხელოვნური ინტელექტით SQL შეკითხვების გენერირება მონაცემთა ანალიზისთვის
დეველოპერები და ანალიტიკოსები სულ უფრო მეტად აფასებენ ხელოვნური ინტელექტის (AI) პოტენციალს მონაცემთა ანალიზის გასამარტივებლად. ტრადიციული SQL შეკითხვების შექმნა მოითხოვდა სპეციალიზებულ ცოდნას, თუმცა AI-ზე დაფუძნებული გადაწყვეტილებები, როგორიცაა MotherDuck-ისა და Numbers Station-ის DuckDB-NSQL-7B მოდელი, ამ პროცესს არა-დეველოპერებისთვისაც ხელმისაწვდომს ხდის. სტატია დეტალურად აღწერს, თუ როგორ შეუძლია ამ LLM-ს ბუნებრივი ენის გამოყენებით SQL ოპერატორების გენერირება, Hugging Face მონაცემთა ნაკრებებთა

Hugging Face Hub-ი Xet-ზე გადავიდა: უხმაურო ტექნოლოგიური რევოლუცია
Hugging Face Hub-მა წარმატებით და თითქმის შეუმჩნევლად მოახდინა მიგრაცია Xet-ის შენახვის სისტემაზე, რომელსაც დღეისათვის 1 მილიონზე მეტი მომხმარებელი იყენებს. მაისიდან Xet Hub-ზე ახალი მომხმარებლებისა და ორგანიზაციებისთვის ნაგულისხმევად იქცა. მიგრაცია განხორციელდა მომხმარებლის მინიმალური ზემოქმედებით, გუნდის წლების გამოცდილების, კონტენტ-მისამართადი საცავის (CAS) და Rust კლიენტის წყალობით. ძირითადი დიზაინერული გადაწყვეტილებები მოიცავდა სამუშაო პროცესის შენარჩუნებას და Xet-ის არა-მხარდამჭერი კლიენტე
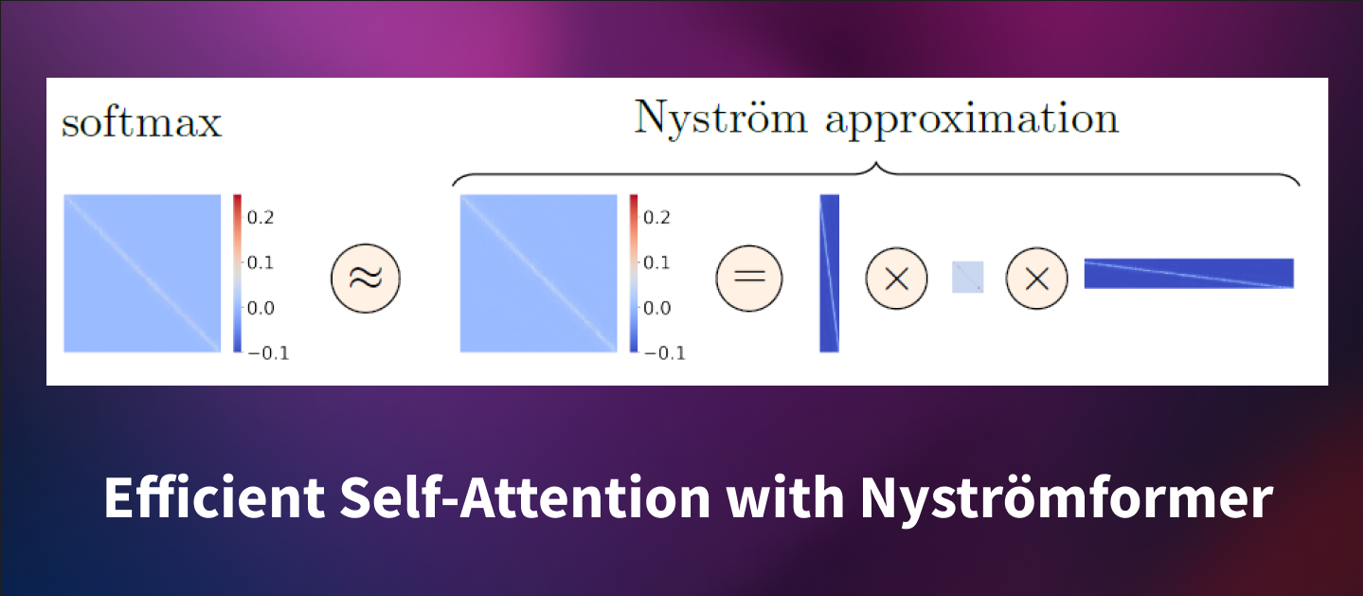
Nyströmformer: ტრანსფორმერების თვითყურადღების მექანიზმის ოპტიმიზაცია ნიუსტრიომის მეთოდით
ტრანსფორმერებმა შთამბეჭდავი შედეგები აჩვენეს ბუნებრივი ენის დამუშავებისა (NLP) და კომპიუტერული ხედვის (CV) ამოცანებში, თუმცა მათი სტანდარტული თვითყურადღების მექანიზმი ხასიათდება O(n²) სირთულით, რაც მის წვრთნას ძვირადღირებულს ხდის გრძელი თანმიმდევრობებისთვის. Nyströmformer წარმოადგენს ეფექტურ ტრანსფორმერულ მოდელს, რომელიც ნიუსტრიომის მეთოდის გამოყენებით სტანდარტულ თვითყურადღებას O(n) სირთულით აპროქსიმირებს. ეს სტატია განმარტავს ნიუსტრიომის მეთოდს და მის ადაპტირებას თვითყურადღების მექანიზმის ოპტიმ

Hugging Face-ისა და Wiz-ის თანამშრომლობა AI პლატფორმის უსაფრთხოებისთვის: Pickle ფაილების გამოწვევა
Hugging Face-მა და ღრუბლოვანი უსაფრთხოების კომპანია Wiz-მა ითანამშრომლეს AI პლატფორმის უსაფრთხოების გასაუმჯობესებლად. Wiz-მა გამოავლინა მოწყვლადობები, განსაკუთრებით pickle ფაილებთან დაკავშირებით, რის შემდეგაც Hugging Face-მა დანერგა უსაფრთხოების გაუმჯობესებები, მათ შორის Wiz-ის ინტეგრაცია მოწყვლადობის მართვისა და ღრუბლოვანი უსაფრთხოების კონტროლისთვის. კომპანია აცხადებს, რომ მოგვარებულია ყველა აღმოჩენილი პრობლემა და ხაზს უსვამს ხელოვნური ინტელექტის სწრაფი განვითარების ფონზე უსაფრთხოებისადმი სერიო
Wiz-ისა და Hugging Face-ის ერთობლივი ძალისხმევა AI პლატფორმის უსაფრთხოების გასაუმჯობესებლად
Hugging Face-მა, Wiz-თან თანამშრომლობით, მნიშვნელოვნად გააუმჯობესა თავისი ხელოვნური ინტელექტის პლატფორმის უსაფრთხოება. Wiz-ის მკვლევრების მიერ გამოვლენილი დაუცველობების საფუძველზე, Hugging Face-მა დანერგა Wiz-ის გადაწყვეტილებები დაუცველობის მართვისა და ღრუბლოვანი უსაფრთხოების მდგომარეობის მართვისთვის (CSPM). სტატია დეტალურად განიხილავს ამ ინტეგრაციის სარგებელს, განსაკუთრებით pickle ფაილებთან დაკავშირებულ რისკებსა და Hugging Face-ის ვალდებულებას, დაიცვას მომხმარებლები და ხელი შეუწყოს AI/ML-ის დემ

ეტინი: უახლესი ენკოდერ-დეკოდერ მოდელები, რომლებიც Llama 3.2 1B-ს და SmolLM2-ს აღემატებიან
რა მოხდებოდა, ModernBERT-ის რეცეპტი მხოლოდ დეკოდერის მოდელზე რომ გამოგვეყენებინა? აღმოჩნდა, რომ შეიქმნებოდა უახლესი დეკოდერული ენის მოდელი, რომელიც Llama 3.2 1B-სა და SmolLM2-ს ჯობნის. ჩვენ წარმოგიდგენთ Ettin-ს, უახლესი, დაწყვილებული მხოლოდ-ენკოდერისა და მხოლოდ-დეკოდერის მოდელების პირველ სერიას (17M-1B პარამეტრი), რომლებიც გაწვრთნილია იდენტური მონაცემებით (2T ტოკენი), არქიტექტურითა და წვრთნის რეცეპტებით. Ettin შესაძლებელს ხდის არქიტექტურებს შორის სამართლიან შედარებებს და უზრუნველყოფს უმაღლეს შეს
Hugging Face Hub: მანქანური სწავლების პროექტების დაჩქარება და კოლაბორაცია
სტატია განიხილავს მანქანური სწავლების (ML) განვითარების გამოწვევებს, როგორიცაა მოდელების პროდუქტიულ ფაზაში ვერ გადასვლა და თანამშრომლობის სირთულეები. წარმოდგენილია Private Hub-ისა და განსაკუთრებით Hugging Face Hub-ის როლი, როგორც ამ პრობლემების გადაწყვეტა. Hugging Face Hub გთავაზობთ ღია წყაროს პლატფორმას მოდელების, მონაცემთა ნაკრებებისა და აპლიკაციების ფართო კოლექციით, Git-ზე დაფუძნებულ რეპოზიტორიებსა და თანამშრომლობით ხელსაწყოებს ML სამუშაო პროცესების დასაჩქარებლად, კვლევიდან დაწყებული წარმოება
Hugging Face: ჩვენი მიდგომა პასუხისმგებლიანი ღიაობისა და პოლიტიკის შემუშავებისადმი
Hugging Face-ის საქმიანობა საზოგადოების საჭიროებებით არის განპირობებული. კომპანია მხარს უჭერს პასუხისმგებლიან ღიაობას, ეთიკაზე ორიენტირებულ კვლევებს და ამ გამოცდილებას კანონმდებლებს უზიარებს.