
LLM შეფასების კრიტიკული ხარვეზები DROP ბენჩმარკში: ნორმალიზაციისა და „გაჩერების ტოკენების“ პრობლემა
Open LLM Leaderboard-ზე DROP ბენჩმარკის დამატების შემდეგ, მოდელების f1-ქულებმა მოულოდნელად დაბალი შედეგები აჩვენა. გამოკვლევამ გამოავლინა ორი ძირითადი პრობლემა: არასწორი ნორმალიზაცია, რომელიც უგულებელყოფდა რიცხვით პასუხებს არასტანდარტული სიცარიელის სიმბოლოების გამო, და წერტილის (.) „გაჩერების ტოკენად“ გამოყენება. ამ ხარვეზების აღმოფხვრა, მათ შორის \n სიმბოლოზე დაყოფა, მნიშვნელოვნად აუმჯობესებს ქულების კორელაციას საერთო შესრულებასთან. თუმცა, სრული ხელახალი შეფასება ძვირი და შრომატევადია, რაც მიუთ

Cloudflare-ისა და FastRTC-ის პარტნიორობა: AI-ზე დაფუძნებული რეალურ დროში კომუნიკაციის გამარტივება
Cloudflare-ისა და Hugging Face-ის FastRTC-ის პარტნიორობა AI დეველოპერებს საშუალებას აძლევს, მინიმალური კოდით შექმნან დაბალლატენტური, ხელოვნურ ინტელექტზე დაფუძნებული აუდიო და ვიდეო ნაკადები. ეს ინტეგრაცია აბსტრაგირებს WebRTC-ის სირთულეებს და იყენებს Cloudflare-ის გლობალურ TURN ქსელს საიმედო კავშირების უზრუნველსაყოფად, რაც დეველოპერებს საშუალებას აძლევს ფოკუსირება მოახდინონ აპლიკაციის ძირითად ლოგიკაზე ინფრასტრუქტურის შენარჩუნების გარეშე. პარტნიორობა ასევე გთავაზობთ 10 GB უფასო მონაცემს ყოველთვიურა
Wav2Vec2: ტრანსფორმერული მოდელების შეზღუდვების დაძლევა ხანგრძლივი აუდიო ფაილების დამუშავებისას
Wav2Vec2, როგორც ტრანსფორმერული მოდელი, აწყდება თანმიმდევრობის სიგრძის შეზღუდვებს, რაც იწვევს პრობლემებს დიდ აუდიო ფაილებთან მუშაობისას. ტრადიციული დაყოფის მეთოდები ხშირად ამცირებს შედეგების ხარისხს კონტექსტის დაკარგვის გამო. ეს სტატია განმარტავს, თუ როგორ იძლევა Wav2Vec2-ის CTC სტრუქტურა საშუალებას, განხორციელდეს მდგრადი მეტყველების ამოცნობა ძალიან დიდ ფაილებზე, „striding“ ტექნიკის გამოყენებით. ასევე განხილულია ენის მოდელების (LM) ინტეგრაცია WER მაჩვენებლის გასაუმჯობესებლად და მოდელის გამოყენებ
LoRA მოდელების ინფერენსის ოპტიმიზაცია ხელოვნურ ინტელექტში: სიჩქარე და ეფექტურობა
ამ ბლოგში დეტალურად განვიხილავთ, თუ როგორ შევძელით საჯარო Diffusion მოდელებზე დაფუძნებული საჯარო LoRA-ებისთვის ინფერენსის სიჩქარის მკვეთრი გაზრდა. ამან მოგვცა რესურსების დაზოგვისა და მომხმარებლისთვის უფრო სწრაფი და უკეთესი გამოცდილების შეთავაზების საშუალება. ჩვენ შევამცირეთ გაშვების საწყისი დრო 25 წამიდან 3 წამამდე, ხოლო მომხმარებლის მოთხოვნებზე პასუხის დრო 35 წამიდან 13 წამამდე. ამჟამად, ასობით განსხვავებული LoRA-ს ინფერენსს ვუზრუნველყოფთ 5-ზე ნაკლები A10G GPU-ით. განვიხილავთ LoRA ტექნიკის არსს

Visual Salamandra: ახალი თაობის მულტიმოდალური AI ევროპული ენების აქცენტით
ენის ტექნოლოგიების ლაბორატორიამ წარმოადგინა Visual Salamandra, ინოვაციური მულტიმოდალური AI მოდელი, რომელიც აერთიანებს Google-ის SigLIP ენკოდერს Salamandra Instructed 7B მოდელთან. ეს სისტემა შექმნილია ვიზუალურ და ტექსტურ მონაცემებს შორის ხარვეზის შესავსებად, რის შედეგადაც მას შეუძლია გაიგოს და შექმნას კონტექსტურად ზუსტი პასუხები მრავალფეროვანი შეყვანის საფუძველზე, მათ შორის სურათებიდან, ვიდეოებიდან და ტექსტური ინსტრუქციებიდან. Visual Salamandra გამოირჩევა მრავალენოვანი ინკლუზიურობით, განსაკუთრები
Visual Salamandra: მულტიმოდალური AI მოდელი ევროპული ენობრივი მრავალფეროვნების მხარდასაჭერად
Visual Salamandra, ახალი მულტიმოდალური ხელოვნური ინტელექტის მოდელი, რომელიც აერთიანებს Google-ის SigLIP ენკოდერს Salamandra Instructed 7B მოდელთან, ხედვისა და ენის დამუშავების უფსკრულს ავსებს. მას შეუძლია გაიგოს და შექმნას კონტექსტურად ზუსტი პასუხები მრავალფეროვანი შეყვანიდან, მათ შორის სურათებიდან, ვიდეოებიდან და ტექსტიდან. ლაბორატორიის მიერ შექმნილი ეს ინოვაცია ხაზს უსვამს მრავალენოვან ინკლუზიურობას, განსაკუთრებული აქცენტით ევროპულ ენებზე, რაც ხელს უწყობს მულტიმოდალური AI კვლევის რესურსების ნა
ემოციური ანალიზი: ყოვლისმომცველი გზამკვლევი პითონის გამოყენებით
ეს სტატია განმარტავს, თუ როგორ გახდა ემოციური ანალიზი, რომელიც ადრე მხოლოდ სპეციალისტებისთვის იყო ხელმისაწვდომი, ახლა ყველასთვის გამოსაყენებელი ხელოვნური ინტელექტის (AI) ინსტრუმენტების წყალობით. იგი მოიცავს ემოციური ანალიზის არსს, მის გამოყენებას მონაცემების ფართომასშტაბიანი დამუშავებისთვის და გაჩვენებთ, თუ როგორ უნდა დაიწყოთ პითონით, Hugging Face Hub-ზე არსებული მოდელების გამოყენებით, მანქანური სწავლის წინასწარი გამოცდილების გარეშე.
სენტიმენტების ანალიზი ყველასთვის: როგორ გამოვიყენოთ ხელოვნური ინტელექტის თანამედროვე ხელსაწყოები
წარსულში სენტიმენტების ანალიზი მხოლოდ სპეციალისტებისთვის იყო ხელმისაწვდომი, მაგრამ ხელოვნური ინტელექტის საზოგადოების მიერ შექმნილმა ინოვაციურმა ხელსაწყოებმა ის ყველასთვის მარტივად ხელმისაწვდომი გახადა. ეს სახელმძღვანელო გვიჩვენებს, თუ როგორ შეიძლება Python-ისა და Hugging Face Hub-ის გამოყენებით ტექსტის ემოციური პოლარობის იდენტიფიცირება, მონაცემების მასშტაბური დამუშავება და მოდელების ოპტიმიზაცია კონკრეტული ამოცანებისთვის, გამოცდილების გარეშეც კი.

Optimum-NVIDIA: LLM-ის ინფერენსის რევოლუციური აჩქარება NVIDIA პლატფორმაზე
Hugging Face-ის Optimum-NVIDIA ბიბლიოთეკა მნიშვნელოვნად აჩქარებს დიდი ენობრივი მოდელების (LLM) ინფერენსს NVIDIA პლატფორმაზე, კოდის მხოლოდ ერთი ხაზის შეცვლით 28-ჯერ უფრო სწრაფ მუშაობას და 1,200 ტოკენს/წამში სიჩქარეს უზრუნველყოფს. ის პირველი Hugging Face ბიბლიოთეკაა, რომელიც სარგებლობს ახალი float8 (FP8) ფორმატით, რაც კიდევ უფრო აუმჯობესებს გამტარუნარიანობას და ამცირებს პირველი ტოკენის ლატენტურობას, რაც საშუალებას იძლევა, უფრო დიდი მოდელები ერთ GPU-ზე გაეშვას სიზუსტის დაკარგვის გარეშე. აღნიშნული ტ

Hugging Face და Protect AI მანქანური სწავლების მოდელების უსაფრთხოების გაძლიერების მიზნით თანამშრომლობენ
2024 წლის ოქტომბერში Hugging Face-მა და Protect AI-მ პარტნიორობა დაიწყეს მანქანური სწავლების (ML) მოდელების უსაფრთხოების გასაუმჯობესებლად. Protect AI-ის Guardian სკანირების ტექნოლოგია Hugging Face Hub-ის მომხმარებლებს კრიტიკულ უსაფრთხოების ინფორმაციას აწვდის. პარტნიორობის ფარგლებში, Protect AI-მ მნიშვნელოვნად გააფართოვა Guardian-ის აღმოჩენის შესაძლებლობები, მოიცვა მეტი ფაილის ფორმატი და გამოავლინა დახვეწილი ობსკურაციის ტექნიკები, მათ შორის მაღალი რისკის CVE-2025-1550 მოწყვლადობა Keras-ში. 2025 წ

გამოსახულებების ტოკენიზაცია და ViT მოდელების დახვეწა გამოსახულების კლასიფიკაციისთვის
ეს სტატია განიხილავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია ტრანსფორმატორის მოდელებისთვის, ნატურალური ენის დამუშავების (NLP) ამოცანების ანალოგიით. დეტალურად არის აღწერილი 🤗 datasets-ისა და 🤗 transformers-ის გამოყენებით ViT (Vision Transformer) მოდელის წინასწარი წვრთნა და დახვეწა გამოსახულების კლასიფიკაციის ამოცანებისთვის. მოცემულია ინსტრუქციები მონაცემთა ჩამოტვირთვის, დამუშავების, გამოსახულების ტრანსფორმაციებისა და წვრთნის კონვეიერის დაყენების შესახებ, მათ შორის ისეთი კომპონენტების, როგორიც
ხელოვნური ინტელექტი: გამოსახულებების ტოკენიზაცია და ViT მოდელების წვრთნა
ეს სტატია განმარტავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია წინადადებების მსგავსად, რაც მათ საშუალებას აძლევს, დამუშავდეს ტრანსფორმერული მოდელებით. დეტალურად არის აღწერილი 🤗 datasets-ის გამოყენებით მონაცემთა მომზადება, ViTImageProcessor-ის ინტეგრირება და წინასწარ გაწვრთნილი ViT მოდელების დაზუსტება. მიმოხილულია ტრენინგის კონფიგურაციის, შეფასების მეტრიკების განსაზღვრისა და ეფექტური წვრთნის კონვეიერის აგების პროცესები, რაც მნიშვნელოვან წინსვლას წარმოადგენს გამოსახულების კლასიფიკაციის ამოცანებშ

Hugging Face AMD Instinct GPU-ების სრულყოფილ მხარდაჭერას აცხადებს ხელოვნური ინტელექტის მოდელებისთვის
AMD-ის უახლესი Instinct MI300 სერიის ამაჩქარებლების მოახლოებულ გამოშვებასთან ერთად, Hugging Face აძლიერებს AMD GPU-ების მხარდაჭერას, რაც მომხმარებლებს საშუალებას აძლევს, გაუშვან Transformers-ის ყველა მოდელი და ამოცანა კოდის ყოველგვარი ცვლილების გარეშე. თანამშრომლობა მოიცავს ინტეგრირებულ ტესტირებას, გარემოსდაცვითი კვალის მინიმიზაციას და მნიშვნელოვან წარმადობის გაუმჯობესებას, განსაკუთრებით დიდი ენობრივი მოდელებისთვის და ტექსტის გენერირების ინფერენციისთვის (TGI), სადაც AMD Instinct MI250 GPU აჭარბე

Hugging Face-ი Pollen Robotics-ს იძენს და ღია რობოტიკის მიმართულებას აძლიერებს
Hugging Face-მა Pollen Robotics შეიძინა, გუნდი, რომელიც 9 წელია ღია კოდის რობოტებს ქმნის. ეს ნაბიჯი Hugging Face-ის LeRobot-ის ინიციატივისა და ღია, ხელმისაწვდომი და კონფიდენციალური ხელოვნური ინტელექტის მქონე რობოტიკის ხედვის განვითარებას ემსახურება, რაც რობოტებს ყველასთვის ხელმისაწვდომს გახდის.
BERT: ხელოვნური ინტელექტის ინოვაცია, რომელმაც ენის დამუშავება შეცვალა
BERT, Google AI-ის მიერ 2018 წელს შექმნილი მანქანური სწავლების მოდელი, რევოლუციური ინოვაციაა ბუნებრივი ენის დამუშავების (NLP) სფეროში. იგი წარმოადგენს მრავალფუნქციურ გადაწყვეტას 11-ზე მეტი ენობრივი ამოცანისთვის, მათ შორის სენტიმენტების ანალიზისა და დასახელებული ერთეულების ამოცნობისთვის. სტატია განმარტავს, თუ როგორ ეხმარება BERT კომპიუტერებს ადამიანის ენის გაგებაში, რა ტექნიკებს (როგორიცაა ნიღბიანი ენის მოდელი და შემდეგი წინადადების პროგნოზირება) იყენებს ამისთვის და რა გავლენა მოახდინა მან Google
SetFitABSA: ინოვაციური მიდგომა ასპექტზე დაფუძნებული სენტიმენტის ანალიზისთვის
SetFitABSA, Intel Labs-ისა და Hugging Face-ის მიერ წარმოდგენილი ფრეიმვორკი, წარმოადგენს ეფექტურ ტექნიკას ტექსტში კონკრეტული ასპექტების მიმართ სენტიმენტის აღმოსაჩენად. ის განკუთვნილია დომენის სპეციფიკური ABSA (ასპექტზე დაფუძნებული სენტიმენტის ანალიზი) მოდელების მცირე მონაცემებით (few-shot) წვრთნისთვის და კონკურენტუნარიანია, უმჯობესდება კიდეც გენერაციულ მოდელებს, როგორიცაა Llama2 და T5. მისი ძირითადი უპირატესობებია პრომპტების არარსებობა და სწრაფი წვრთნის შესაძლებლობა მცირე რაოდენობის ეტიკეტირებული

HELMET: ყოვლისმომცველი ბენჩმარკი გრძელკონტექსტური ენობრივი მოდელების შესაფასებლად
HELMET, რომელიც გასულ ოქტომბერს გამოვიდა, გახდა პოპულარული ინსტრუმენტი გრძელკონტექსტური ენობრივი მოდელების (LCLM) შესაფასებლად, რომელსაც იყენებენ ისეთი კომპანიები, როგორებიცაა Microsoft და AI21. მუდმივად განვითარებადი LCLM-ების გათვალისწინებით, HELMET გთავაზობთ ახალ, გაფართოებულ შეფასების მეთოდებს, რომლებიც წარმოდგენილი იქნება ICLR 2025-ზე. ეს ბენჩმარკი მიზნად ისახავს გადაჭრას არსებული შეფასების მეთოდების ნაკლოვანებები, უზრუნველყოფს მოდელების მრავალფეროვან, კონტროლირებად და საიმედო შედარებას რეა
შეზღუდული სხივური ძიება: კონტროლი ტექსტის გენერაციის პროცესზე
ეს სტატია განიხილავს ტექსტის გენერაციის გაუმჯობესებულ მეთოდს – შეზღუდულ სხივურ ძიებას (constrained beam search). ჩვეულებრივი სხივური ძიებისგან განსხვავებით, ეს მეთოდი საშუალებას გვაძლევს ზუსტი კონტროლი მოვახდინოთ გენერირებულ გამოსავალზე. ის წყვეტს იმ გამოწვევებს, როდესაც საჭიროა კონკრეტული სიტყვების ან ფრაზების ჩართვა, მრავალი შეზღუდვის დაწესება ან ალტერნატიული სიტყვის ფორმების გათვალისწინება (განმყოფი შეზღუდვები). ამ მიდგომით, ტექსტის გენერაცია ხდება უფრო კონტექსტზე მორგებული და მომხმარებლის მი
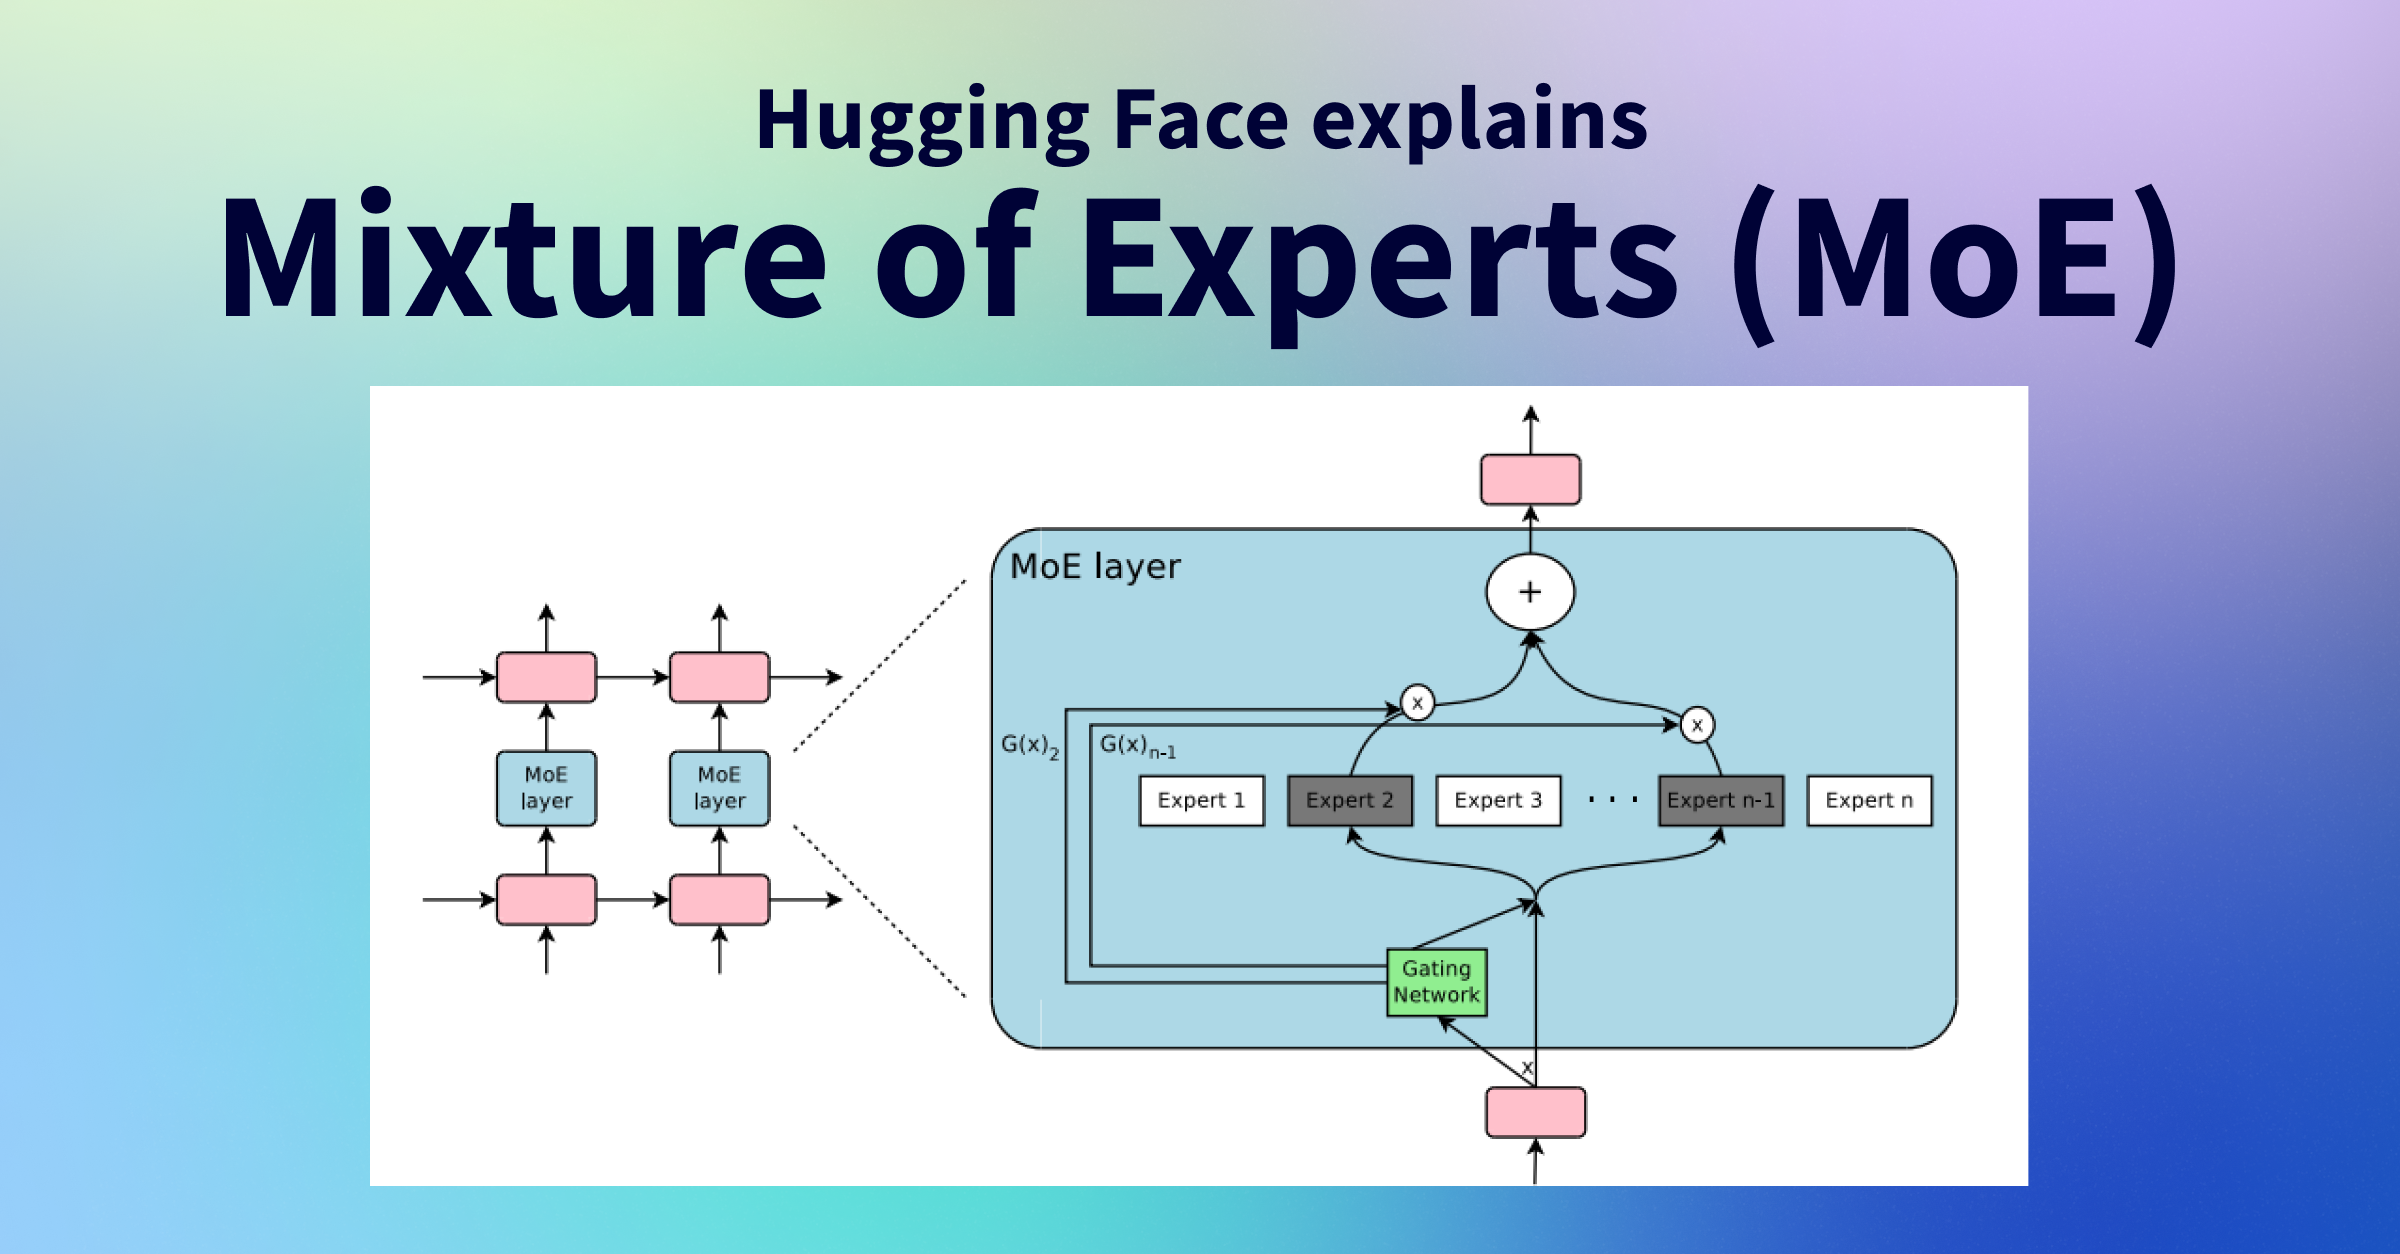
ექსპერტთა ნაზავი (MoEs): სიღრმისეული მიმოხილვა და იშვიათი მოდელების როლი
ექსპერტთა ნაზავი (MoEs) წარმოადგენს მნიშვნელოვან მიღწევას ხელოვნურ ინტელექტში, რომელიც საშუალებას აძლევს მოდელებს, მიაღწიონ უკეთეს ხარისხს გაცილებით ნაკლები გამოთვლითი რესურსებით. MoEs-ის მეშვეობით შესაძლებელია მოდელის ან მონაცემთა ნაკრების ზომის მნიშვნელოვნად გაზრდა მკვრივ მოდელებთან შედარებით, ერთი და იგივე ბიუჯეტის პირობებში, რაც უზრუნველყოფს უფრო სწრაფ წინასწარ წვრთნას. სტატია განმარტავს MoE-ის კონცეფციას ტრანსფორმერული მოდელების კონტექსტში, განიხილავს მის შემადგენელ ნაწილებს (კარიბჭის ქსელი

Cohere Hugging Face Hub-ზე: ინოვაციური AI მოდელები საწარმოებისთვის
კომპანია Cohere Hugging Face Hub-ის მხარდაჭერილი ინფერენს პროვაიდერი გახდა, რაც პირველი შემთხვევაა, როდესაც მოდელის შემქმნელი პირდაპირ ემსახურება საკუთარ მოდელებს პლატფორმაზე. Cohere, თავისი ყოვლისმომცველი, უსაფრთხო AI გადაწყვეტილებებით, რომელიც მოიცავს გენერაციულ AI-ს, ემბედინგსა და რანჟირების მოდელებს, განკუთვნილია საწარმოო გამოყენებისთვის. მათი მოდელები, როგორებიცაა Command R+, Aya, Command R და Aya Vision, ახლა ხელმისაწვდომია უსერვერო ინფერენსისთვის, რაც ხაზს უსვამს მრავალენოვან მხარდაჭერას,
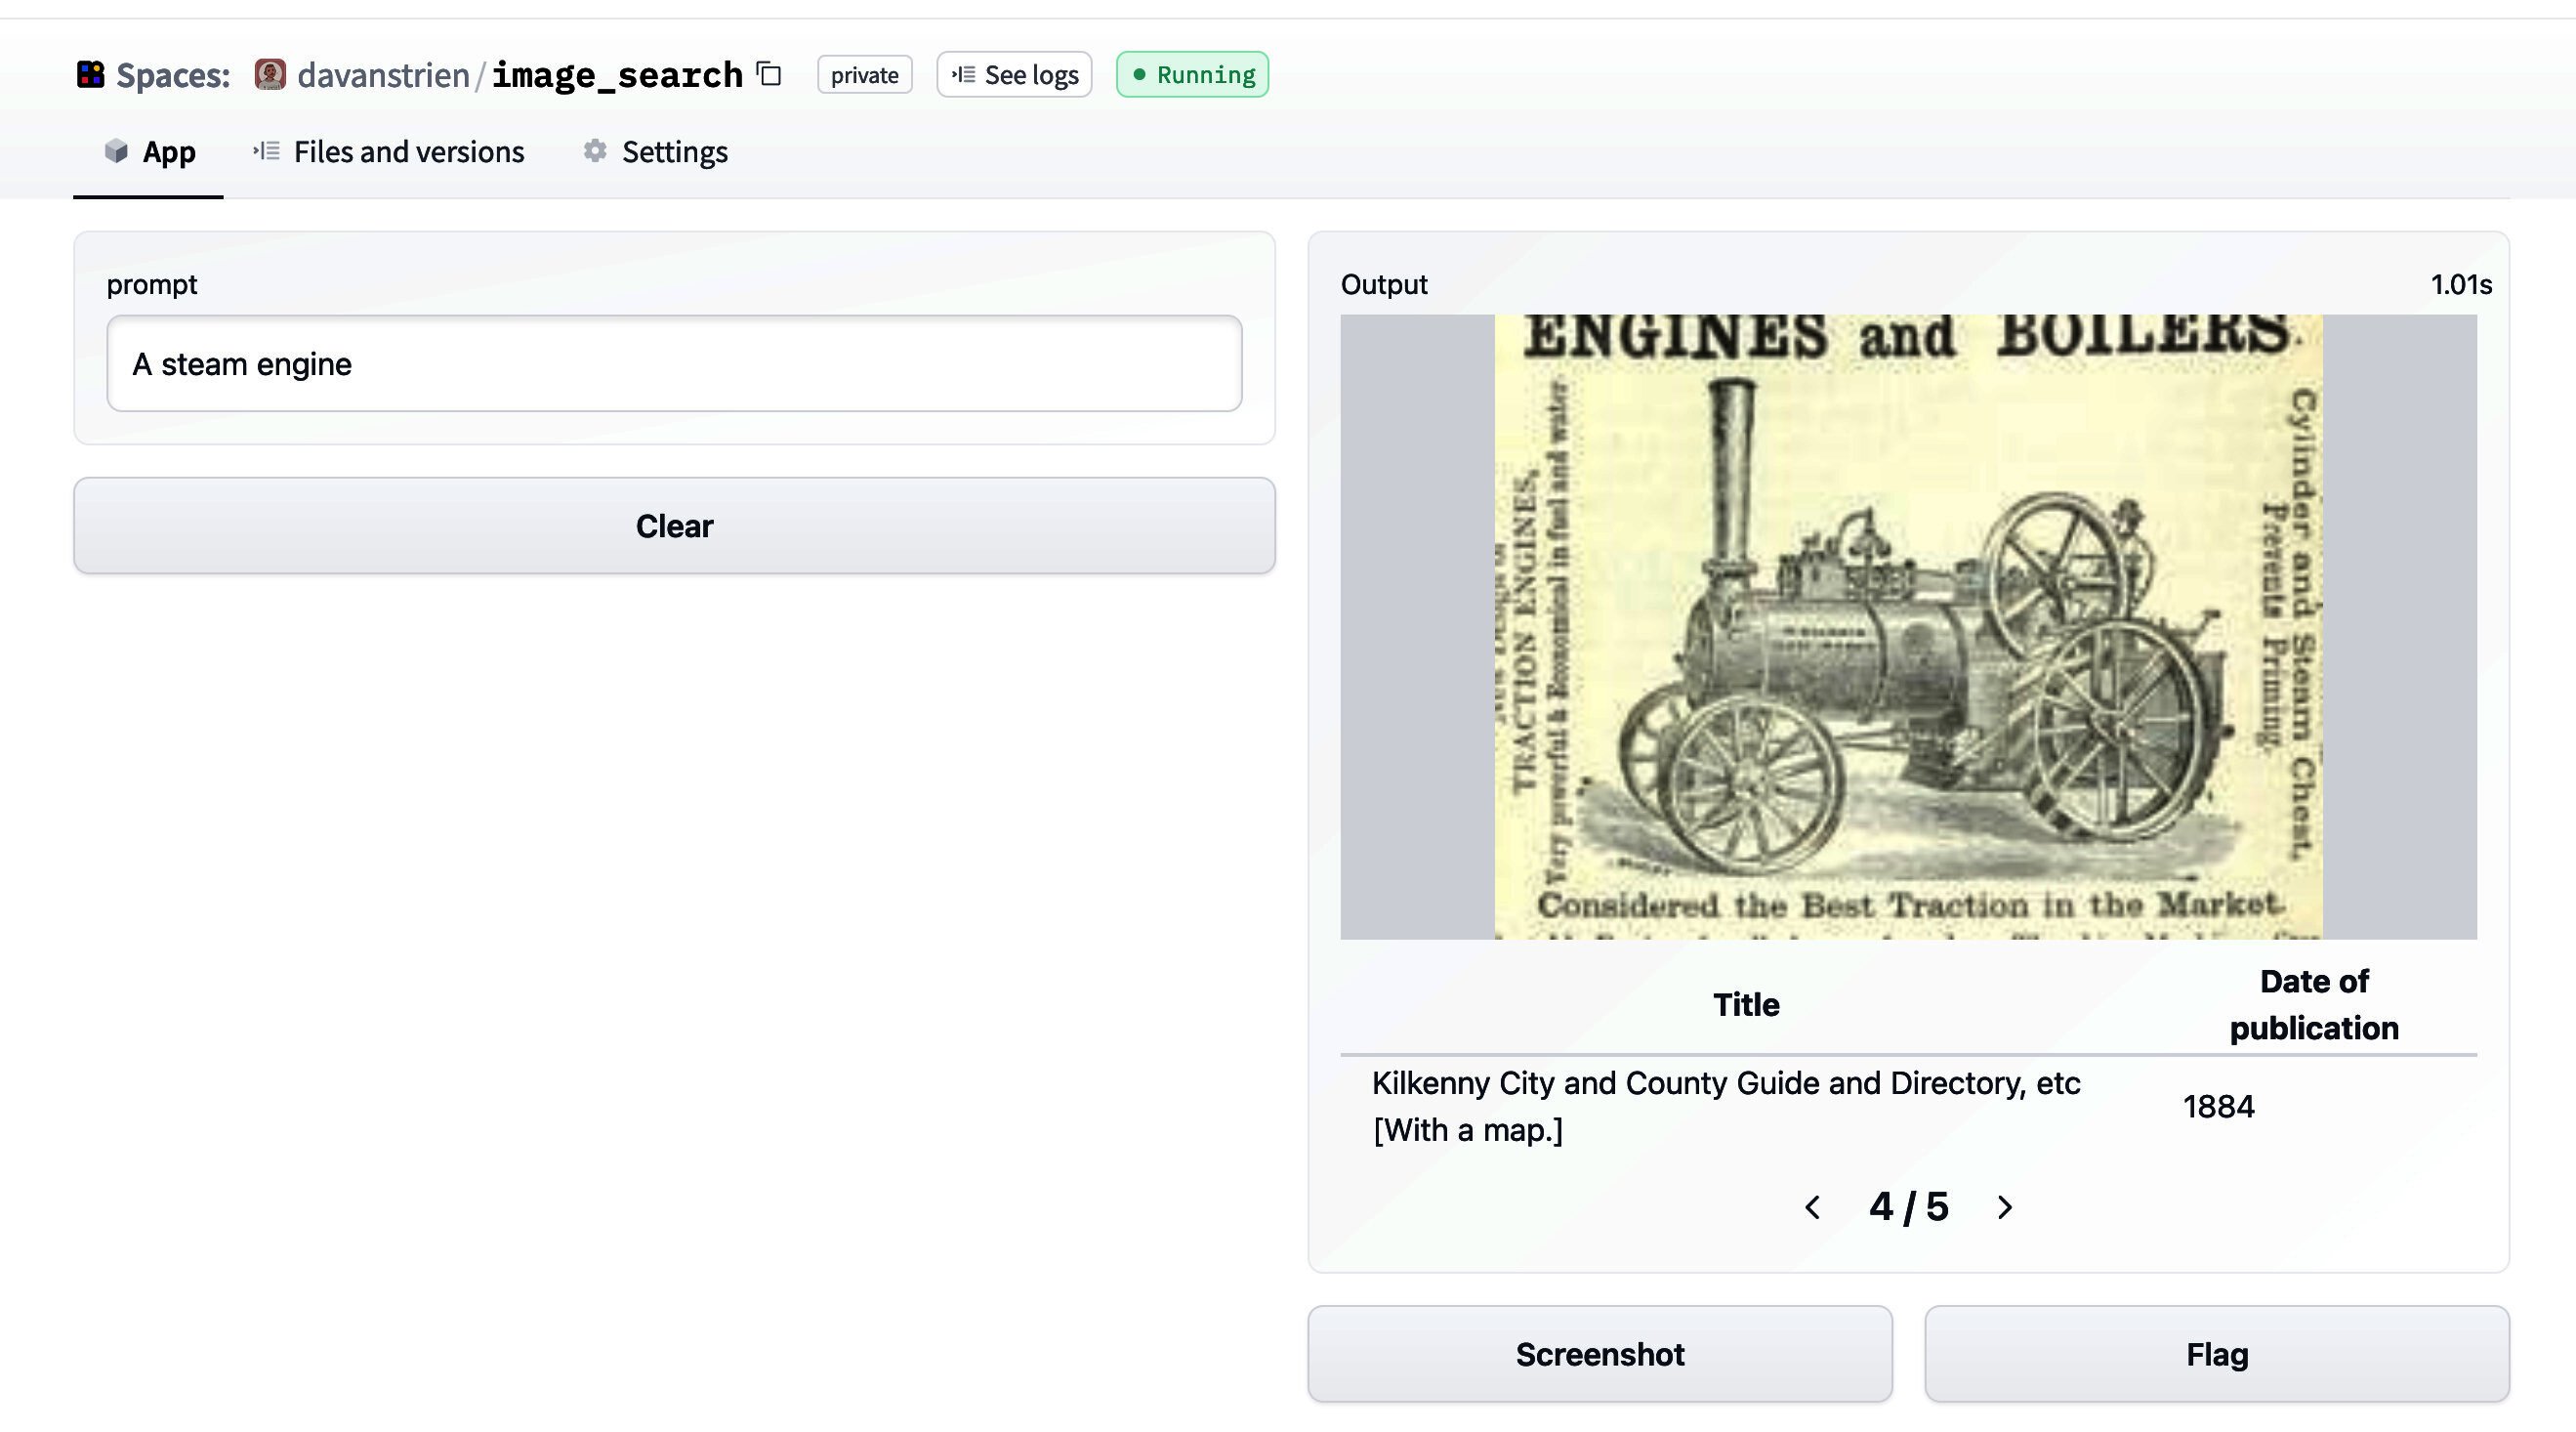
`datasets` ბიბლიოთეკა: ახალი შესაძლებლობები სურათების ძიებისთვის
თავდაპირველად ტექსტურ მონაცემებთან ასოცირებული `datasets` ბიბლიოთეკა ახლა გაძლიერებულ მხარდაჭერას გვთავაზობს აუდიო და სურათებისთვის. ეს სტატია განიხილავს, თუ როგორ შეიძლება `datasets`-ის, `sentence_transformers`-ისა და `faiss`-ის გაერთიანებით სურათების საძიებო აპლიკაციის შექმნა, ბრიტანეთის ბიბლიოთეკის ციფრული კოლექციიდან მიღებული სურათების მაგალითზე.
Mixtral-ის გამოშვება: ახალი ნახტომი ხელოვნურ ინტელექტში ექსპერტთა ნაზავი (Mixture of Experts) არქიტექტურით
სტატია წარმოგიდგენთ Mixtral-ს, ახალ დიდ ენობრივ მოდელს (LLM), რომელიც იყენებს ექსპერტთა ნაზავის (MoE) არქიტექტურას, აერთიანებს 8 „ექსპერტ“ მოდელს ერთში. ხაზგასმულია Mixtral-ის შთამბეჭდავი წარმადობა, რომელიც აჭარბებს სხვა ღია წვდომის მოდელებს და უტოლდება GPT-3.5-ს MT-Bench ბენჩმარკზე. განმარტებულია მისი რეალური პარამეტრების რაოდენობა (დაახლოებით 45B, არა 56B) და დეტალურად აღწერილია მისი გამოყენება ინფერენციისა და ფაინ-თუნინგისთვის, ასევე Hugging Face-ზე განთავსების შესაძლებლობები.

Gradio: ყოვლისმომცველი ჩარჩო AI/ML აპლიკაციების შესაქმნელად – მეტი, ვიდრე უბრალო UI ბიბლიოთეკა
Gradio, რომელიც ხშირად აღიქმება მხოლოდ UI ბიბლიოთეკად, სინამდვილეში არის ყოვლისმომცველი ჩარჩო მანქანური სწავლების მოდელებთან ურთიერთობისთვის UI-ებისა და API-ების მეშვეობით, რომელიც უზრუნველყოფს მაღალ შესრულებას, უსაფრთხოებასა და რეაგირებას. სტატია დეტალურად განიხილავს Gradio-ს უნიკალურ მახასიათებლებს, როგორებიცაა API Recorder, სერვერული რენდერინგი (SSR), დახვეწილი რიგების სისტემა, სტრიმინგი, მრავალგვერდიანი აპლიკაციების მხარდაჭერა, Groovy ტრანსპილაცია, თემების სისტემა, დინამიური რენდერინგი, Grad
Gradio: მეტი ვიდრე უბრალოდ UI ბიბლიოთეკა – ხელოვნური ინტელექტის აპლიკაციების მძლავრი ჩარჩო
Gradio, რომელიც ხშირად მხოლოდ UI ბიბლიოთეკად აღიქმება, სინამდვილეში არის ყოვლისმომცველი ჩარჩო მანქანური სწავლების მოდელებთან ინტერფეისებისა და API-ების მეშვეობით ურთიერთობისთვის, რაც უზრუნველყოფს მაღალ წარმადობას, უსაფრთხოებასა და რეაგირებას. ეს სტატია წარმოგიდგენთ მის უნიკალურ მახასიათებლებს, რომლებიც გადამწყვეტია თანამედროვე AI აპლიკაციების შესაქმნელად.