Renumics Spotlight: ინტერაქტიული ვიზუალიზაცია და მონაცემთა ინსპექცია Hugging Face-ის მონაცემთა ნაკრებებისთვის
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს Hugging Face-ის მონაცემთა ნაკრებებში კრიტიკული კლასტერების იდენტიფიცირებისთვის. ის იყენებს მოდელის შედეგებს (პროგნოზები, ემბედინგები) მონაცემთა სეგმენტებისა და მოდელის შეცდომების ღრმა გაგებისთვის, რაც აადვილებს მონაცემთა ინსპექციას და ხდის მას მასშტაბირებადს. ხელსაწყო პირდაპირ ინტეგრირდება `datasets` ბიბლიოთეკასთან და მხარს უჭერს სხვადასხვა ტიპის მონაცემებსა და ML ამოცანებს, მათ შორის NLP, აუდიო და კომპიუტერული ხედვა.
Renumics Spotlight: გაამარტივეთ მონაცემთა ინსპექტირება Hugging Face ეკოსისტემაში
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს, რომლებიც ეხმარება მომხმარებლებს კრიტიკული კლასტერების იდენტიფიცირებაში Hugging Face მონაცემთა ნაკრებებში. ინსტრუმენტი უპრობლემოდ ინტეგრირდება Hugging Face-ის ეკოსისტემასთან, საშუალებას გაძლევთ გამოიყენოთ მოდელის შედეგები, როგორიცაა პროგნოზები და ემბედინგები, რათა ღრმად შეისწავლოთ მონაცემთა სეგმენტები და მოდელის ხარვეზები. Spotlight მნიშვნელოვნად ზრდის მონაცემთა ინსპექტირების მასშტაბურობას, ამარტივებს სამუშაო პროცესებს და ამცირებს დროის ხარ

TGI ახლა პირდაპირ მხარს უჭერს Intel Gaudi აპარატურას
გაცხადდა Intel Gaudi აპარატურის სრული ინტეგრაცია TGI-ის ძირითად კოდბაზაში, რაც გამორიცხავს ცალკეული „ფორკების“ საჭიროებას. ეს ახალი მრავალბექენდური არქიტექტურა ამარტივებს გამოყენებას, უზრუნველყოფს TGI-ის უახლეს ფუნქციებზე წვდომას და ოპტიმიზაციას უკეთებს დიდი ენობრივი მოდელების (LLMs) მუშაობას Gaudi მოწყობილობებზე. განცხადება ასევე ხაზს უსვამს მოწინავე ფუნქციებს, მოსალოდნელ მოდელებს და საზოგადოებისგან უკუკავშირის მიღების მოწვევას.
Hugging Face-ი Gradio-ს იძენს: მანქანური სწავლის ხელმისაწვდომობის ახალი ეტაპი
მანქანური სწავლის სტარტაპ Gradio-ს Hugging Face-ის მიერ შეძენა მნიშვნელოვანი ნაბიჯია ხელოვნური ინტელექტის დემოკრატიზაციისკენ. ეს შერწყმა საშუალებას მისცემს დეველოპერებს, მონაცემთა მეცნიერებს და არატექნიკურ მომხმარებლებს, უფრო მარტივად შექმნან, გააზიარონ, გამოიყენონ და შეაფასონ მანქანური სწავლის მოდელები. გაერთიანებული ძალებით, Hugging Face და Gradio ისახავენ მიზნად, რომ ხელოვნური ინტელექტი ხელმისაწვდომი გახადონ ყველასთვის, ვისაც ინტერნეტთან წვდომა აქვს, რაც კიდევ უფრო გააფართოვებს ინოვაციების შე
კოდის გენერაციის მოდელების პერსონალიზაცია: HugCoder-ის შექმნა და თქვენი საკუთარი Copilot-ის შესაძლებლობები
მიუხედავად იმისა, რომ წინასწარ გაწვრთნილი ხელოვნური ინტელექტის მოდელები შთამბეჭდავად მუშაობენ სხვადასხვა ამოცანებში, მომავალი შესაძლებლობა მდგომარეობს კოდის გენერაციის მოდელების კონკრეტულ საჭიროებებზე მორგებაში, რაც ქმნის პერსონალიზებულ კოდირების ასისტენტებს საწარმოო მასშტაბით. ეს ბლოგ-პოსტი წარმოგიდგენთ HugCoder-ს – კოდის დიდ ენობრივ მოდელს (LLM), რომელიც დამატებით გაიწრთვნა Hugging Face-ის GitHub-ის საჯარო რეპოზიტორიებიდან შეგროვებულ კოდის შიგთავსზე. დეტალურად განვიხილავთ მონაცემთა შეგროვების,
Hugging Face: როგორ გააუმჯობესეს საიდუმლოებების მართვა Infisical-ით და გაზარდეს უსაფრთხოება
Hugging Face-ის საინჟინრო გუნდმა, მრავალღრუბლოვანი ინფრასტრუქტურის პირობებში, საიდუმლოებების მართვის გაუმჯობესების მიზნით, Infisical აირჩია. ამ ქეის-სტადიაში დეტალურად არის აღწერილი მიგრაციის პროცესი, Infisical-ის ისეთი ფუნქციების ინტეგრაცია, როგორიცაა Kubernetes ოპერატორი, CI/CD ინტეგრაცია და დეტალური RBAC სისტემა. აღნიშნული გადაწყვეტილებით Hugging Face-მა მნიშვნელოვნად გააუმჯობესა უსაფრთხოება, გაამარტივა სამუშაო პროცესები და გაზარდა ინჟინრების ეფექტურობა საიდუმლოებების ცენტრალიზებული და უსაფრთ
Hugging Face: კონფიდენციალური მონაცემების ცენტრალიზებული მართვა Infisical-ით
Hugging Face-ის ინფრასტრუქტურის მრავალღრუბლოვან გარემოში განვითარებასთან ერთად, საინჟინრო გუნდმა მოითხოვა კონფიდენციალური მონაცემების მართვის უფრო მოქნილი, უსაფრთხო და ცენტრალიზებული მეთოდი. HashiCorp Vault-ის მსგავსი გადაწყვეტილებების შეფასების შემდეგ, მათ აირჩიეს Infisical მისი დეველოპერებისთვის მოსახერხებელი სამუშაო პროცესების, მრავალღრუბლოვანი აბსტრაქციისა და უსაფრთხოების მძლავრი შესაძლებლობების გამო. ამ მიგრაციამ მნიშვნელოვნად გააუმჯობესა უსაფრთხოების პოზიცია Kubernetes Operator-თან, CI/CD
AutoNLP და Prodigy: ხელოვნური ინტელექტის მოდელების სწრაფი და ეფექტური შექმნა
სტატია მიმოიხილავს Hugging Face-ის AutoNLP-სა და Explosion-ის Prodigy-ს, ორ მძლავრ ინსტრუმენტს ღრმა სწავლის მოდელების შესაქმნელად და მონაცემთა ანოტაციისთვის. აღწერილია, თუ როგორ ამარტივებს AutoNLP უახლესი ტრანსფორმატორის მოდელების წვრთნას სხვადასხვა ბუნებრივი ენის დამუშავების ამოცანებისთვის (კლასიფიკაცია, სახელობითი ერთეულების ამოცნობა) მინიმალური კოდირებით. Prodigy წარმოდგენილია როგორც მოქნილი, რეალურ დროში ანოტაციის ინსტრუმენტი, რომელიც მხარს უჭერს ბუნებრივი ენის დამუშავების, კომპიუტერული მხედ
ახალი რეგიონების ფუნქცია: სად შეინახოთ თქვენი მონაცემები და რატომ არის ეს მნიშვნელოვანი
ეს ბლოგ პოსტი განიხილავს ახალ ფუნქციას, რომელიც მომხმარებლებს საშუალებას აძლევს აირჩიონ თავიანთი მონაცემების (მოდელები და მონაცემთა ნაკრებები) შენახვის რეგიონი. ეს უზრუნველყოფს მონაცემთა რეზიდენტურის მოთხოვნებთან შესაბამისობას (მაგ. GDPR) და მნიშვნელოვნად აუმჯობესებს ატვირთვისა და ჩამოტვირთვის სიჩქარეს. სტატიაში ასევე აღწერილია, თუ როგორ უნდა დავაყენოთ ეს ფუნქცია.

LLM ინფერენციის სამართლიანი დაგეგმვა: გამოწვევები და გადაწყვეტები
სტატია მიმოიხილავს LLM ინფერენციის ძრავებში (მაგ. vLLM, HuggingFace TGI) სამართლიანი დაგეგმვის გამოწვევებს, სადაც GPU-ზე ჯგუფური დამუშავება ეფექტურია, თუმცა ერთი მომხმარებელი ხშირად მონოპოლიზებს ბექენდის რიგს. TNG-ის მიერ შემოთავაზებული გადაწყვეტა მოიცავს ცალკე API სერვერს ("LLM-სერვერს"), რომელიც მართავს მოთხოვნებს ინფერენციის ძრავამდე. ეს სერვერი იყენებს თითოეული მომხმარებლისთვის ცალკეულ რიგებს და "მრგვალი მაგიდის" (round-robin) პრინციპით დაგეგმვას სამართლიანობისთვის. ის ასევე ითვალისწინებს მო
GPT-J-ის ეფექტური დეპლოირება Amazon SageMaker-ისა და Hugging Face-ის გამოყენებით
სტატია განიხილავს EleutherAI-ის GPT-J მოდელის წარმოებაში ინტეგრაციის გამოწვევებს, განსაკუთრებით მეხსიერების მოხმარებისა და ჩატვირთვის ხანგრძლივი დროის თვალსაზრისით. ის წარმოადგენს გადაწყვეტას Amazon SageMaker-ისა და Hugging Face Inference Toolkit-ის გამოყენებით, PyTorch-ის მოდელების შენახვის ოპტიმიზებული მეთოდის მეშვეობით, რაც მნიშვნელოვნად ამცირებს ჩატვირთვის დროს (1 წუთი და 23 წამიდან 7.7 წამამდე) და GPT-J-ს საწარმოო სცენარებისთვის თავსებადს ხდის.
NLP მოდელების შედარებითი ანალიზი: RoBERTa, Mistral-7b და Llama-2-7b LoRA-ს გამოყენებით კატასტროფის ტვიტების კლასიფიკაციისთვის
ბუნებრივი ენის დამუშავების (NLP) სწრაფად განვითარებად სამყაროში, ენობრივი მოდელების შედარება გადამწყვეტია მათი ოპტიმალური გამოყენებისთვის კონკრეტულ ამოცანებში. ეს პოსტი ეძღვნება სამი მოდელის – RoBERTa, Mistral-7b და Llama-2-7b – შედარებას კატასტროფების შესახებ ტვიტების კლასიფიკაციის პრობლემაში. კვლევაში გამოყენებულია PEFT (Parameter-Efficient Fine-Tuning) ტექნიკის LoRA (Low-Rank Adaptation) მეთოდი, რომელიც მნიშვნელოვნად ამცირებს პარამეტრების რაოდენობას მოდელის წვრილად მორგებისას. განხილულია თითო

Hugging Face-ის სასწავლო პლატფორმის მასშტაბური განახლება: NLP კურსი ახლა LLM კურსია
Hugging Face აცხადებს hf.co/learn პლატფორმის მასშტაბურ განახლებას, რომლის ფარგლებშიც პოპულარული NLP კურსი LLM კურსად გარდაიქმნა. ეს ცვლილება ასახავს ხელოვნური ინტელექტის სფეროში მიმდინარე სწრაფ განვითარებას, ამატებს ახალ თავებს დიდი ენობრივი მოდელების დახვეწასა და მსჯელობის მოდელების შექმნაზე, აფართოებს საზოგადოებასთან თანამშრომლობას და გეგმავს სერტიფიცირების პროგრამას მომავალში.
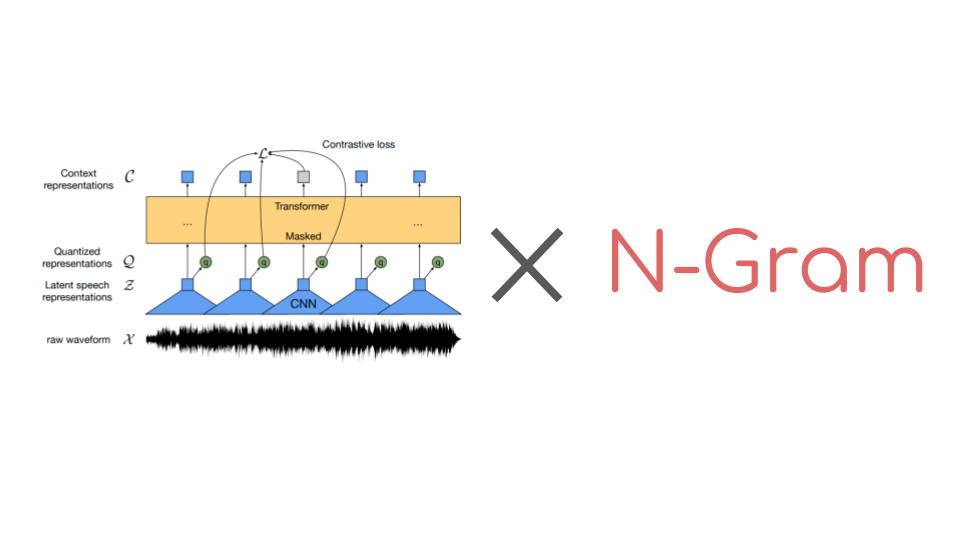
Wav2Vec2: ენობრივი მოდელების ინტეგრაცია ზუსტი მეტყველების ამოცნობისთვის
ეს სტატია განმარტავს, თუ როგორ უნდა დავაზუსტოთ Wav2Vec2 მოდელები მეტყველების ამოცნობისთვის და მნიშვნელოვნად გავაუმჯობესოთ ტრანსკრიფციის სიზუსტე ენობრივი მოდელის (LM) ინტეგრაციით. აღწერილია Connectionist Temporal Classification (CTC) ალგორითმის გამოყენება და დეტალურადაა განხილული pyctcdecode ბიბლიოთეკისა და 🤗 Transformers-ის საშუალებით n-გრამული ენობრივი მოდელის შექმნისა და Wav2Vec2 ჩეკპოინტთან შერწყმის ნაბიჯ-ნაბიჯ პროცესი, განსაკუთრებით ხაზგასმულია გაუმჯობესება მოკლე სასწავლო მონაცემთა ნაკრებებზ
Prodigy-HF: Hugging Face მოდელების გაწვრთნა და ანოტირებული მონაცემთა ნაკრებების გაზიარება
Explosion-მა გამოუშვა Prodigy-HF, ახალი პლაგინი, რომელიც Prodigy-ის ანოტაციის ხელსაწყოს Hugging Face-ის ეკოსისტემასთან აინტეგრირებს. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს, გაწვრთნან Hugging Face მოდელები საკუთარ ანოტირებულ მონაცემებზე (მაგ. დასახელებული ერთეულების ამოცნობისთვის და ტექსტის კლასიფიკაციისთვის) და გამოაქვეყნონ ეს მონაცემთა ნაკრებები Hugging Face Hub-ზე, რაც ხელს უწყობს მოქნილობას, თანამშრომლობას და დროის დაზოგვას ხელოვნური ინტელექტის პროექტებში.

Gradio-ს 5-წლიანი გზა: როგორ გახდა ის AI ვებ აპლიკაციების სტანდარტი
5 წლის წინ Stanford-ის მკვლევრებისთვის შექმნილი Gradio დღეს მილიონობით დეველოპერს ეხმარება AI ვებ აპლიკაციების შექმნასა და გაზიარებაში. სტატია მიმოიხილავს Gradio-ს ზრდის სტრატეგიებს, მათ შორის, დაბალდონიანი API-ების განვითარებას მაღალი დონის აბსტრაქციების ნაცვლად, ვიწრო, მზარდ ნიშაზე ფოკუსირებას (ML ვებ აპლიკაციები) და მომხმარებლებისთვის გაზიარების მარტივი მექანიზმების შეთავაზებას.
Hugging Face Infinity: ტრანსფორმერული მოდელების ოპტიმალური განთავსება Intel Xeon CPU-ებზე
Hugging Face Infinity არის კონტეინერიზებული გადაწყვეტა, რომელიც საშუალებას აძლევს კომპანიებს ეფექტურად განათავსონ ტრანსფორმერული მოდელები წარმოებაში დაბალი ლატენტურობითა და მაღალი გამტარუნარიანობით. ეს ბლოგ პოსტი წარმოადგენს დეტალურ წარმადობის შედეგებს Infinity-ის უახლესი თაობის Intel Xeon CPU-ებზე გაშვებისას (კერძოდ, Ice Lake-ზე დაფუძნებული EC2 C6i ინსტანსებზე), რაც უზრუნველყოფს ოპტიმალურ ღირებულებას, ეფექტურობასა და ლატენტურობას თქვენი Transformer-ის განთავსებისთვის.
Llama 2-ის ეფექტური განთავსება AWS Inferentia2-ზე Hugging Face Optimum Neuron-ის მეშვეობით
Hugging Face-ის ბლოგზე ადრე წარდგენილი AWS Inferentia2-ის გაფართოების შედეგად, ახლა შესაძლებელია დიდი ენობრივი მოდელების (LLM) განთავსება ტექსტის გენერაციისთვის AWS Inferentia2 ინსტანციებზე Optimum Neuron-ის გამოყენებით. სტატია დეტალურად აღწერს Llama 2-ის განთავსების პროცესს, გთავაზობთ რეკომენდაციებს Hugging Face Neuron Deep Learning AMI-ზე ან Amazon SageMaker-ზე განთავსების შესახებ და განმარტავს მოდელების კომპილაციასა და ექსპორტს. ასევე, მოცემულია Inferentia2-ზე ტექსტის გენერაციის ეფექტურობის ა

Meta-ს Llama 4-ის მოდელები გამოვიდა: წინ გადადგმული ნაბიჯი მულტიმოდალურ ხელოვნურ ინტელექტში MoE არქიტექტურითა და გაფართოებული კონტექსტით
Meta-ს მიერ შემუშავებული Llama 4-ის მოდელები, Maverick და Scout, დღეს გამოვიდა, რაც ხელოვნური ინტელექტის სფეროში მნიშვნელოვან წინსვლას წარმოადგენს. ეს მძლავრი, მშობლიურად მულტიმოდალური მოდელები იყენებენ ახალ ავტორეგრესიულ „ექსპერტთა ნაზავის“ (MoE) არქიტექტურას, რაც მათ საშუალებას აძლევს დაამუშაონ როგორც ტექსტური, ისე გამოსახულების შეტანა. Hugging Face-ის ეკოსისტემასთან სრულყოფილი ინტეგრაციის უზრუნველყოფით, Llama 4-ის მოდელები გაწვრთნილია 200 ენაზე (40 ტრილიონამდე ტოკენზე) და გამოირჩევა კონტექსტი
Meta-მ Llama 4 მულტიმოდალური AI მოდელები გამოუშვა Hugging Face-ის ეკოსისტემისთვის
დღეს Meta-მ წარმოადგინა Llama 4-ის ახალი თაობის მძლავრი, მშობლიურად მულტიმოდალური AI მოდელები – Maverick და Scout. ეს მოდელები მნიშვნელოვან წინ გადადგმულ ნაბიჯს წარმოადგენს ხელოვნური ინტელექტის განვითარებაში, რომლებიც ინტეგრირებულია Hugging Face-ის ეკოსისტემაში. Llama 4 იყენებს ინოვაციურ ავტორეგრესიულ ექსპერტთა ნარევის (MoE) არქიტექტურას და მხარს უჭერს უზარმაზარ კონტექსტის სიგრძეებს (Scout-ისთვის 10 მილიონამდე ტოკენი), ასევე ტექსტური და გამოსახულების შეტანის დამუშავებას. მოდელები გაწვრთნილია 200
Stable-Baselines3-ისა და Hugging Face Hub-ის ინტეგრაცია: მოდელების განთავსება, ჩატვირთვა და გაზიარება
ეს სტატია წარმოგიდგენთ Stable-Baselines3-ისა და Hugging Face Hub-ის ინტეგრაციას, რაც მომხმარებლებს საშუალებას აძლევს მარტივად განათავსონ, ჩატვირთონ და გააზიარონ ღრმა განმტკიცებითი სწავლის მოდელები. მოცემულია სახელმძღვანელო, თუ როგორ გამოიყენოთ ეს ახალი ფუნქციონალი, მათ შორის საჭირო ბიბლიოთეკების ინსტალაცია, საზოგადოების მოდელების პოვნა, გაწვრთნილი აგენტების ატვირთვა და საზოგადოებასთან ურთიერთობა ეკოსისტემის სამომავლო გაფართოებისთვის.
Stable Diffusion-ისა და SDXL-ის რევოლუციური დაჩქარება LCM LoRA-ს მეშვეობით
დღეს წარმოდგენილია ინოვაციური მეთოდი, LCM LoRA, რომელიც მნიშვნელოვნად აჩქარებს Stable Diffusion-ისა და SDXL მოდელების გამოსახულების გენერირების პროცესს. ეს სიახლე მათ თითქოს LCM დისტილაციის პროცესით დამუშავებულს ხდის და საშუალებას აძლევს SDXL მოდელებს იმუშაონ დაახლოებით 1 წამში (3090 GPU-ზე, 7 წამის ნაცვლად) ან 10-ჯერ უფრო სწრაფად Mac-ზე, რაც ხსნის ახალ შესაძლებლობებს რეალურ დროში აპლიკაციებისთვის და გამოსახულების გენერირების სამუშაო პროცესებისთვის.

არაბული AI მოდელების შეფასების პლატფორმისა და AraGen ეტალონის მნიშვნელოვანი განახლებები
მიმდინარე ძალისხმევის ფარგლებში, წარმოდგენილია მნიშვნელოვანი განახლებები არაბული AI მოდელების შეფასების პლატფორმაზე. ამოქმედდა Arabic-Leaderboards, რომელიც არაბული ენის მოდელების შეფასებისთვის ერთიან სივრცეს წარმოადგენს. დეკემბერში დაინერგა AraGen ეტალონი დინამიური შეფასების მეთოდოლოგიით, სადაც მონაცემთა ნაკრები სამი თვის განმავლობაში კონფიდენციალური რჩება სამართლიანი შეფასებისთვის. გაფართოვდა AraGen მონაცემთა ნაკრები და დაიხვეწა შემფასებელი სისტემის მოთხოვნები. მიუხედავად იმისა, რომ ახალმა განა
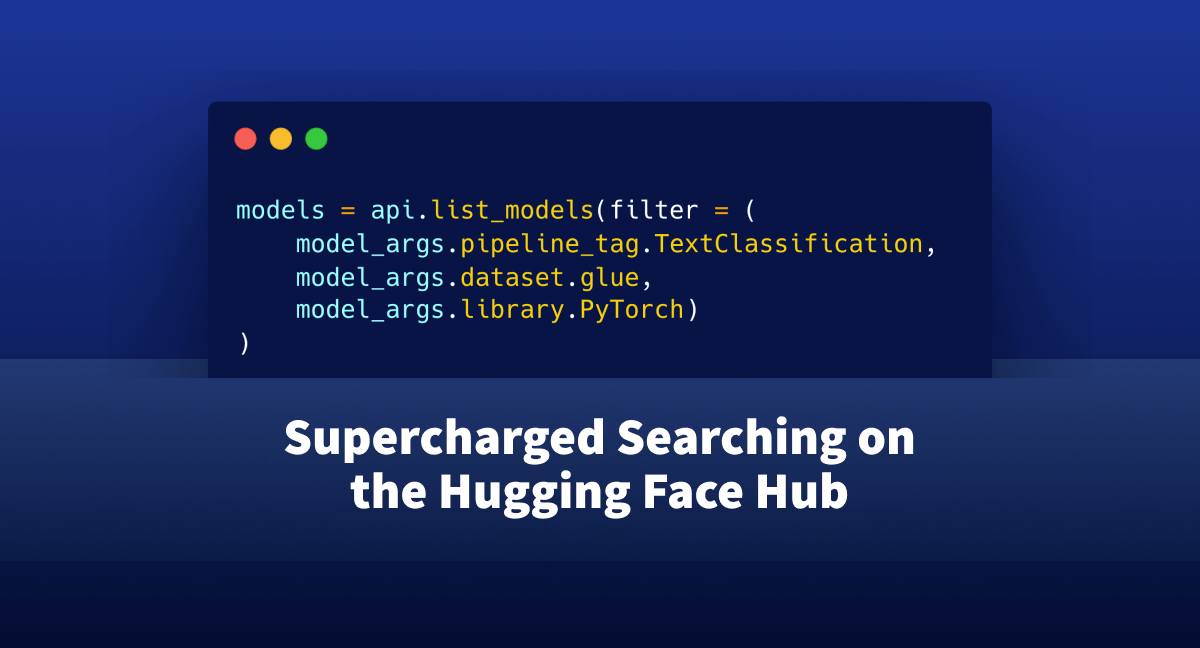
Hugging Face Hub-ის ძიების გამარტივება: პროგრამული ინტერფეისის ახალი შესაძლებლობები
სტატიაში წარმოდგენილია `huggingface_hub` ბიბლიოთეკის ახალი ფუნქციები, `ModelSearchArguments` და `ModelFilter`, რომლებიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე AI მოდელებისა და მონაცემთა ნაკრებების ძიებას პირდაპირ Python-ის ან Jupyter-ის გარემოდან. ეს სიახლე დეველოპერებს საშუალებას აძლევს, არ დატოვონ IDE და ეფექტურად მართონ რთული მოთხოვნები, რაც მნიშვნელოვნად აუმჯობესებს სამუშაო პროცესს.