
AI-ის ძალა მუსიკალურ შემოქმედებაში: Arm-ის პროცესორებით სტუდიური ხმის გენერაცია პირდაპირ მოწყობილობაზე
პროგრამისტმა და მუსიკალურმა პროდიუსერმა შექმნა ინოვაციური აპლიკაცია, რომელიც Arm-ზე დაფუძნებული CPU-სა და ღია კოდის AI მოდელების გამოყენებით, პირდაპირ მოწყობილობაზე გენერირებს სტუდიური ხარისხის ჟღერადობას. ეს ინსტრუმენტი უზრუნველყოფს სწრაფ, პირად და შეუფერხებელ სამუშაო პროცესს მუსიკალური პროდიუსერებისთვის, რაც მათ საშუალებას აძლევს, წამებში შექმნან უნიკალური ხმები მარტივი მოთხოვნებით, ყოველგვარი ღრუბლოვანი სერვისების ან GPU-ს საჭიროების გარეშე. პროექტი გვიჩვენებს კონტენტის შექმნის მომავალს მოწყო
Sempre Health-მა Hugging Face-ის დახმარებით შემომავალი შეტყობინებების 20%-ის ავტომატური დამუშავება დაიწყო
Sempre Health-მა Hugging Face-თან თანამშრომლობით დანერგა ახალი NLP პაიპლაინი, რომელმაც შემომავალი შეტყობინებების ავტომატური კლასიფიცირება და რეაგირება დაიწყო. ამ ინოვაციამ მნიშვნელოვნად გაზარდა ბიზნესის მასშტაბურობა და გუნდის ეფექტურობა, რადგან ახლა ყოველდღიური შეტყობინებების 20%-ზე მეტი სისტემის მიერ ავტომატურად მუშავდება. „ექსპერტთა აჩქარების პროგრამამ“ Sempre Health-ს საშუალება მისცა სწრაფად განეხორციელებინა ეს ცვლილება და შეემცირებინა დაბალღირებული სამუშაო დატვირთვა.
Open Ko-LLM ლიდერბორდი: კორეული ხელოვნური ინტელექტის განვითარების ახალი ეტაპი
Upstage-მა 2023 წლის სექტემბერში Open Ko-LLM ლიდერბორდი წარადგინა, რომლის მიზანიც კორეული დიდი ენობრივი მოდელების (LLM) შეფასების ეკოსისტემის შექმნა და გამჭვირვალობის ხელშეწყობა იყო. პლატფორმა, რომელიც კორეული ენის უნიკალურ მახასიათებლებს ითვალისწინებს, მოკლე დროში დიდი პოპულარობით სარგებლობს, 5 თვეში 1000-ზე მეტი მოდელის წარდგენით. მიუხედავად ინფრასტრუქტურული გამოწვევებისა, ლიდერბორდი აქტიურად ვითარდება, რათა რეალურ სამყაროში გამოყენების შემთხვევებს უკეთ მოერგოს და კორეული AI-ის განვითარებას ხე

KV ქეშირება nanoVLM-ში: 38%-იანი აჩქარება გენერაციაში
ეს ბლოგ-პოსტი აღწერს KV ქეშირების ტექნიკას, რომელიც nanoVLM საცავში ნულიდან დავნერგეთ და რომელმაც ენობრივი მოდელების გენერაციაში 38%-იანი აჩქარება მოგვცა. სტატია განმარტავს ავტორეგრესიულ მოდელებში გამოთვლითი სიჭარბის პრობლემას და იმას, თუ როგორ აგვარებს მას KV ქეშირება Q, K, V მნიშვნელობების შენახვით. მოცემულია თეორიული საფუძვლები, nanoVLM-ში პრაქტიკული იმპლემენტაცია და ზოგადი გაკვეთილები, რომლებიც ყველა ავტორეგრესიული ენობრივი მოდელის გენერაციას ეხება. ეს ოპტიმიზაცია აუცილებელია LLM-ების ეფექტუ
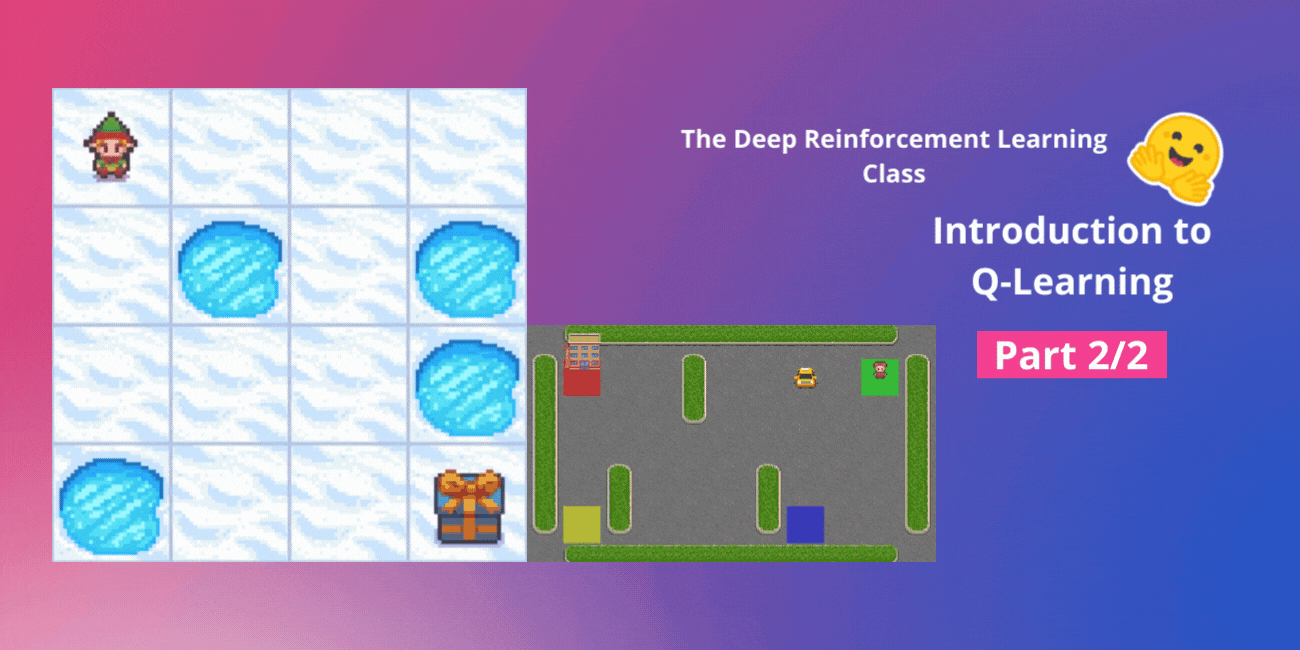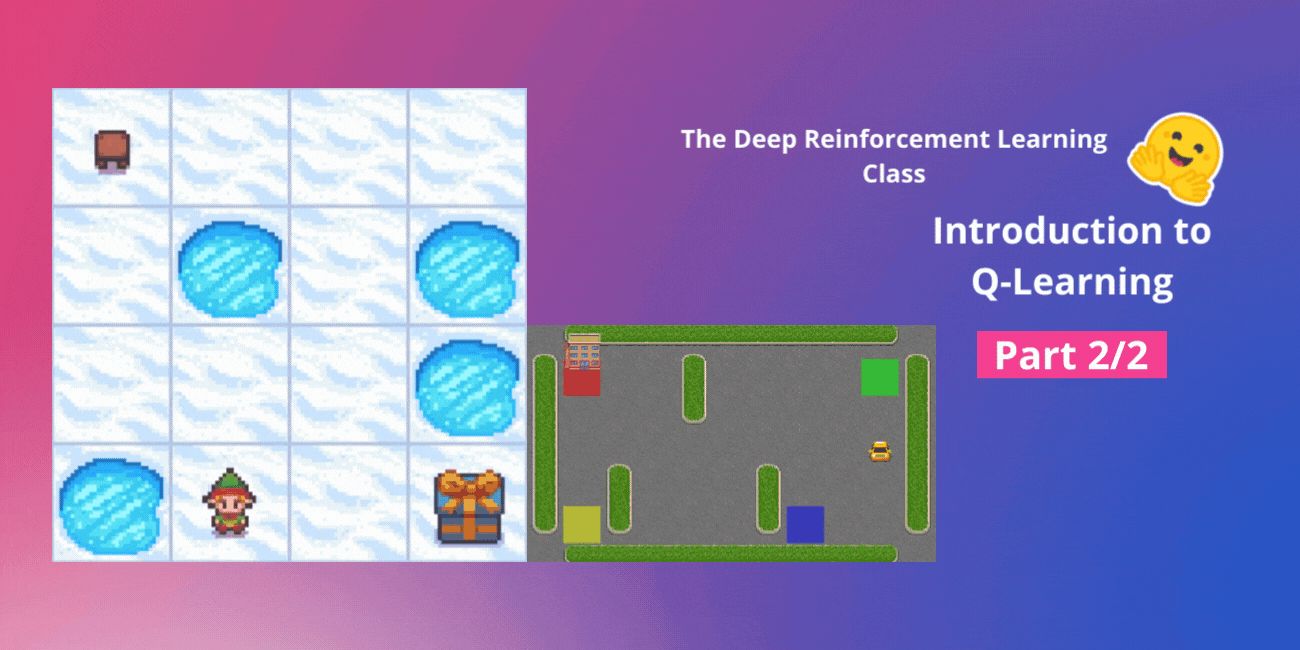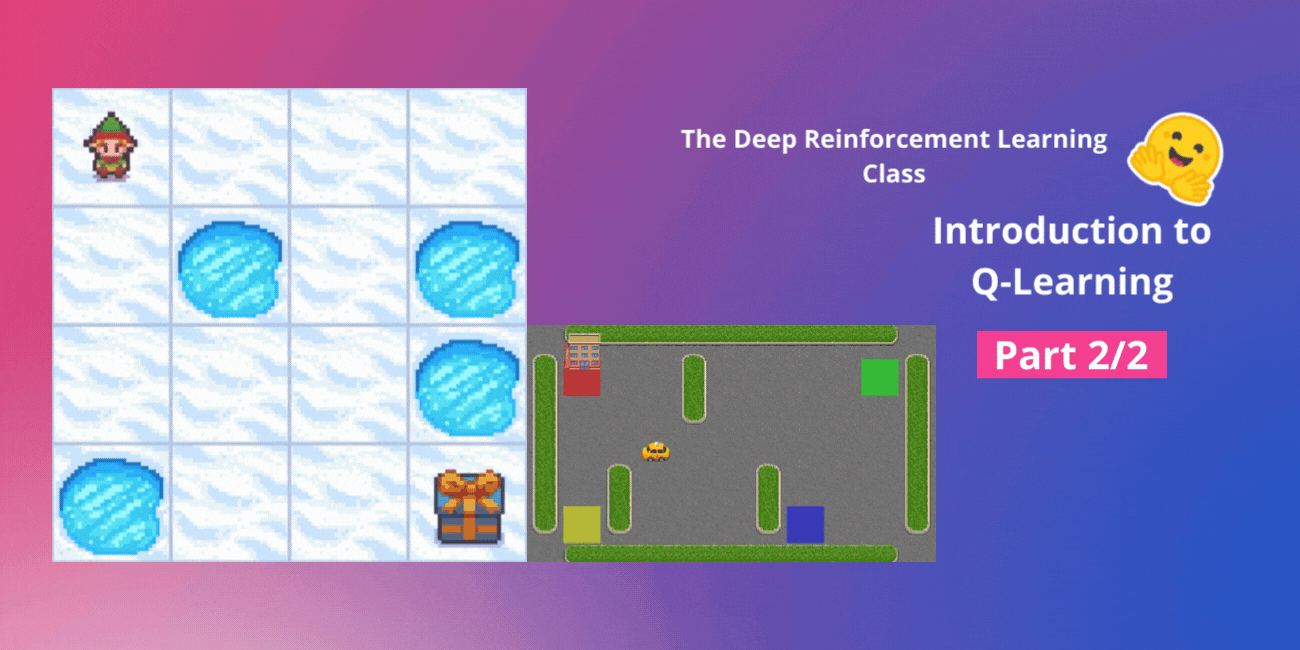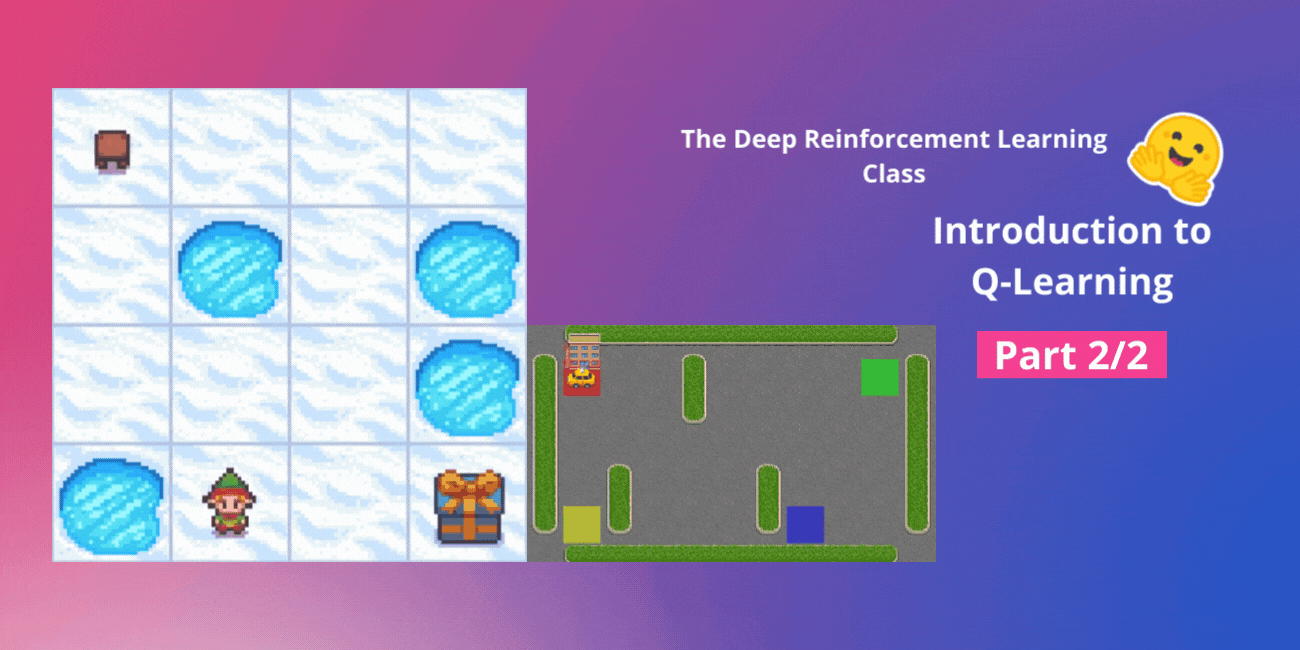
Q-სწავლა: ნულიდან RL აგენტის შექმნის გზამკვლევი
აღმოაჩინეთ Q-სწავლის ალგორითმი, ღრმა გაძლიერებითი სწავლის კლასის ფუნდამენტური ნაწილი. ეს სტატია განმარტავს Q-ფუნქციის, Q-ცხრილისა და ეფსილონ-ხარბი სტრატეგიის მუშაობის პრინციპებს, გასწავლით თუ როგორ შექმნათ თქვენი პირველი გაძლიერებითი სწავლის აგენტი ნულიდან და განაახლოთ მისი ქცევის მოდელი გარემოსთან ურთიერთქმედებისას.
Google-მა Gemma, უახლესი ღია LLM-ების ოჯახი გამოუშვა
Google-მა დღეს გამოუშვა Gemma, ხელოვნური ინტელექტის (AI) უახლესი ღია ენის მოდელების (LLM) ოჯახი, რაც აძლიერებს კომპანიის ერთგულებას ღია კოდის AI მიმართ. Gemma ხელმისაწვდომია ორი ზომის (7B და 2B პარამეტრი) და ორი ვარიანტის (ძირითადი და ინსტრუქციებზე მორგებული) სახით. ის შექმნილია ეფექტური გამოყენებისთვის სხვადასხვა მოწყობილობაზე, მათ შორის სამომხმარებლო GPU-ებზე, CPU-ებზე და ჩაშენებულ სისტემებზე. Hugging Face-თან თანამშრომლობით უზრუნველყოფილია სრული ინტეგრაცია და ყველა ვარიანტი ხელმისაწვდომია Hug

ScreenSuite: ახალი სტანდარტი GUI აგენტებისა და VLM-ების შეფასებაში
ბოლო კვირების განმავლობაში, ინტენსიური მუშაობის შედეგად, შევქმენით GUI აგენტების მუშაობის შეფასების უმსხვილესი ბენჩმარკინგ პლატფორმა – ScreenSuite. ეს არის ყველაზე ყოვლისმომცველი და მარტივი გზა Vision Language Models (VLM)-ების მრავალ აგენტურ შესაძლებლობაზე შესაფასებლად, რაც მიზნად ისახავს AI აგენტების ხელმისაწვდომობისა და ინტეგრაციის გაუმჯობესებას.
TAPEX: რევოლუციური მიდგომა ცხრილის წინასწარი ვარჯიშისთვის ნერვული SQL შემსრულებლის მეშვეობით
ნაშრომში „TAPEX: ცხრილის წინასწარი ვარჯიში ნერვული SQL შემსრულებლის სწავლით“ წარმოდგენილია ინოვაციური მეთოდი, რომელიც იყენებს სინთეზურ მონაცემებს და ნერვულ SQL შემსრულებელს ცხრილების წინასწარი ვარჯიშისთვის. ეს მიდგომა უზრუნველყოფს პროგრამების მრავალფეროვნებასა და მასშტაბს, რაც გაუვალია ბუნებრივი ენის მოდელებისთვის. TAPEX-მა აჩვენა რეკორდული შედეგები სხვადასხვა ამოცანებზე, მათ შორის ცხრილის კითხვებზე პასუხის გაცემასა და ფაქტების გადამოწმებაზე, რითაც მნიშვნელოვნად აჯობა წინა მეთოდებს და მიაღწია 50
მატრიოშკა Embeddings-ის მოდელები: მოქნილობა და ეფექტურობა ხელოვნურ ინტელექტში
ეს სტატია განიხილავს მატრიოშკა Embeddings-ის მოდელებს, რომლებიც გვთავაზობენ მოქნილობასა და ეფექტურობას ბუნებრივი ენის დამუშავებასა და ხელოვნურ ინტელექტში. განმარტებულია მათი მუშაობის პრინციპი, რომელიც რუსული მატრიოშკის თოჯინების მსგავსად, საშუალებას იძლევა, Embeddings-ის ზომა შემცირდეს ინფორმაციის მნიშვნელოვანი დაკარგვის გარეშე. სტატია ასევე მოიცავს პრაქტიკულ რჩევებს მათი გამოყენებისა და ტრენინგის მეთოდებზე, მათ შორის Sentence Transformers-ის ფარგლებში, ხაზს უსვამს მათ უპირატესობებს ტრადიციულ Em

Hugging Face და NVIDIA AI კვლევისთვის GPU რესურსებს ხელმისაწვდომს ხდიან „ტრენინგ კლასტერი როგორც სერვისი“ (TCaaS) მეშვეობით
Hugging Face და NVIDIA აცხადებენ თანამშრომლობის შესახებ და წარმოადგენენ „ტრენინგ კლასტერი როგორც სერვისი“ (TCaaS) ინიციატივას. ეს პლატფორმა მიზნად ისახავს AI-ის მკვლევრებისთვის და ორგანიზაციებისთვის GPU კლასტერებზე ხელმისაწვდომობის გაფართოებას, რათა მათ შეძლონ ხელოვნური ინტელექტის მოდელების ეფექტურად მომზადება. სერვისი გთავაზობთ მოქნილ გადახდის მოდელს, რაც რესურსების მოთხოვნისამებრ გამოყენების საშუალებას იძლევა და ამცირებს „გამოთვლითი რესურსების ხარვეზს“.
Hugging Face Hub-ზე ახალი კოლაბორაციული ფუნქციები: Pull Requests და Discussions
Hugging Face Hub სიხარულით აცხადებს Pull Requests-ისა და Discussions-ის გამოშვებას, რომლებიც დღეიდან ხელმისაწვდომია ყველა ტიპის რეპოზიტორისთვის („Community“ ჩანართში). ეს ფუნქციები ხელს შეუწყობს თანამშრომლობას საზოგადოების წევრებს შორის, გუნდებში და მის ფარგლებს გარეთ, რაც უდიდესი განახლებაა Hub-ისთვის და შეესაბამება ეთიკური მანქანური სწავლების პრინციპებს.
Haize Labs-ი Hugging Face-ის მხარდაჭერით LLM-ების „წითელი გუნდის“ წინააღმდეგობის ახალ ბენჩმარკს წარადგენს
ხელოვნური ინტელექტის (AI) სფეროში, დიდი ენობრივი მოდელების (LLM) უსაფრთხოებასა და არასასურველ ქცევებთან დაკავშირებით მზარდი შეშფოთებაა. ამ გამოწვევის საპასუხოდ, Haize Labs-მა, Hugging Face-ის გუნდის მხარდაჭერით, შექმნა „Red Teaming Resistance Benchmark“ – ახალი საორიენტაციო სისტემა. ის მიზნად ისახავს უახლესი LLM მოდელების მდგრადობის შემოწმებას ადამიანის მიერ შემუშავებული, დახვეწილი „წითელი გუნდის“ (red teaming) შეტევების გამოყენებით, რათა გამოავლინოს მათი სისუსტეები და მოწყვლადობები. ბენჩმარკი ფ
Haize Labs-მა და Hugging Face-მა დიდი ენობრივი მოდელების უსაფრთხოების ახალი ეტალონი, „წითელი გუნდის წინააღმდეგობის ბენჩმარკი“ წარადგინეს
დიდი ენობრივი მოდელების (დემ) კვლევის სწრაფი ტემპის ფონზე, Haize Labs-მა, Hugging Face-ის გულუხვი მხარდაჭერით, გამოაქვეყნა „წითელი გუნდის წინააღმდეგობის ბენჩმარკი“ (Red Teaming Resistance Benchmark). ეს ახალი ეტალონი მიზნად ისახავს მოწინავე დემ-ების მოწყვლადობების საფუძვლიან შემოწმებას ადამიანის მიერ შექმნილი, ბუნებრივი ენის მსგავსი მავნე მოთხოვნების (prompts) გამოყენებით, განსხვავებით ხელოვნური, ავტომატიზებული შეტევებისგან. ბენჩმარკი აფასებს მოდელების მდგრადობას არასასურველი ქცევების მიმართ, რო

NVIDIA Isaac GR00T N1.5: ინტელექტუალური რობოტების შექმნის ახალი ეტაპი
NVIDIA-მ გამოაცხადა Isaac GR00T N1.5-ის გამოშვება, რომელიც წარმოადგენს მსოფლიოში პირველი ღია ფუნდამენტური მოდელის, Isaac GR00T N1-ის, უმნიშვნელოვანეს განახლებას განზოგადებული ჰუმანოიდური რობოტების მსჯელობისა და უნარებისთვის. ეს პლატფორმა შექმნილია ინტელექტუალური, ადაპტირებადი რობოტების შექმნის დასაჩქარებლად, მრავალმხრივი შეყვანის (ენა, გამოსახულებები) დამუშავებით და მრავალფეროვან გარემოში მანიპულაციური ამოცანების შესასრულებლად. GR00T N1.5 ახლა ხელმისაწვდომია დეველოპერებისთვის, რაც მათ საშუალებას
Graphcore და Hugging Face 10 ტრანსფორმერული მოდელის ხელმისაწვდომობას აფართოებენ AI ამოცანებისთვის
სტატია დეტალურად აღწერს, თუ როგორ გააფართოვეს Graphcore-მა და Hugging Face-მა, მათი პარტნიორობის მეშვეობით, 10 ტრანსფორმერულ მოდელზე წვდომა დეველოპერებისთვის, რომლებიც მოიცავს ბუნებრივი ენის დამუშავებას (NLP), მეტყველებასა და კომპიუტერულ ხედვას. ხაზგასმულია ძირითადი მოდელები, როგორიცაა BERT, ViT, GPT-2, RoBERTa, DeBERTa, BART, LXMERT, T5, HuBERT და Wav2Vec2, მათი უნიკალური ფუნქციონალური შესაძლებლობებისა და გამოყენების სფეროების ახსნით, რაც ამარტივებს ხელოვნური ინტელექტის განვითარებას IPU-ებზე.
Hugging Face: Gemma მოდელების PEFT-ით ოპტიმიზაცია
ამ პოსტში განხილულია, თუ როგორ შეიძლება Gemma მოდელების პარამეტრულად ეფექტური წვრილმანი მორგება (PEFT) Hugging Face Transformers-ისა და PEFT ბიბლიოთეკების გამოყენებით GPU-ებსა და Cloud TPU-ებზე. ეს ტექნიკა განსაკუთრებით გამოსადეგია მეხსიერებისა და გამოთვლითი რესურსების დაზოგვისთვის, რაც საშუალებას აძლევს მომხმარებლებს, მათ შორის მათ, ვინც Colab-სა და Kaggle-ზე მუშაობს, ოპტიმიზაცია გაუკეთონ მოდელებს საკუთარ მონაცემთა ნაკრებებზე დაბალი დანახარჯით. სტატია დეტალურად განიხილავს LoRA-სა და QLoRA-ს გამ

Featherless AI Hugging Face Hub-ის მხარდაჭერილი ინფერენს პროვაიდერი გახდა
Featherless AI უერთდება Hugging Face Hub-ის მზარდ ეკოსისტემას, აფართოებს სერვერული ინფერენციის შესაძლებლობებს და მომხმარებლებს სთავაზობს მოდელების შეუდარებელ მრავალფეროვნებას ხელმისაწვდომ ფასად. ის მხარს უჭერს უახლეს ღია კოდის მოდელებს DeepSeek-დან, Meta-დან, Google-დან და Qwen-დან, რაც აერთიანებს მოდელების დიდ არჩევანს სერვერულ ფასებთან.
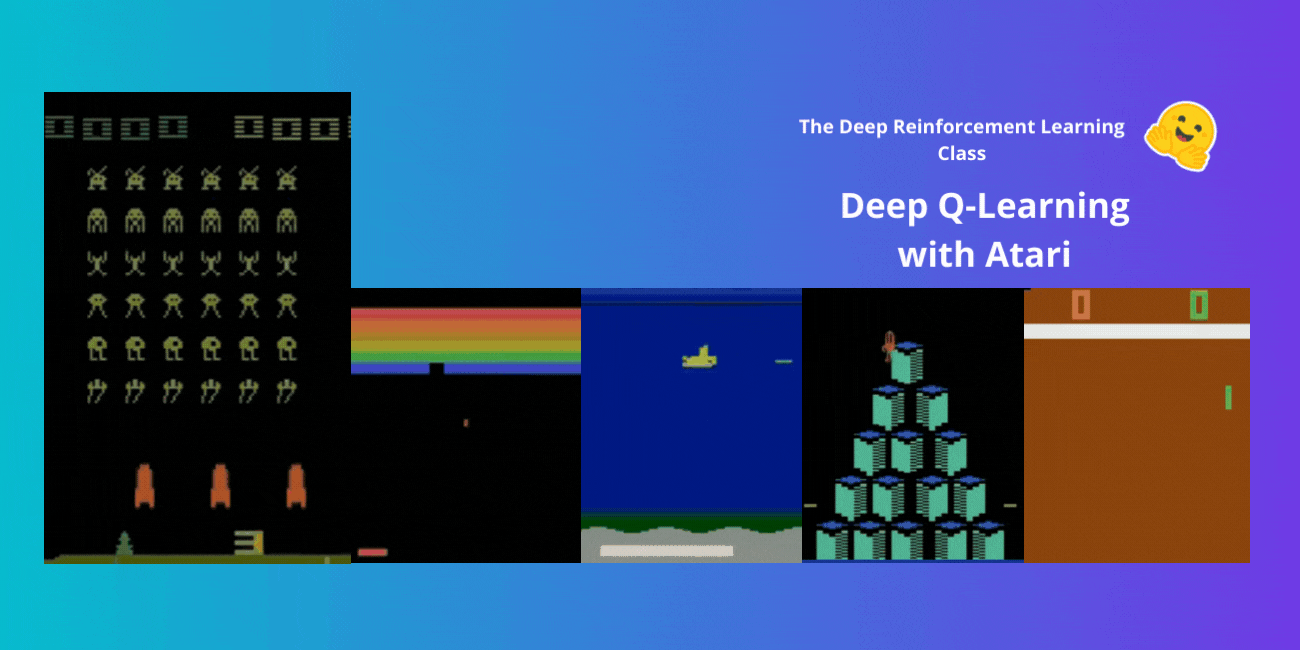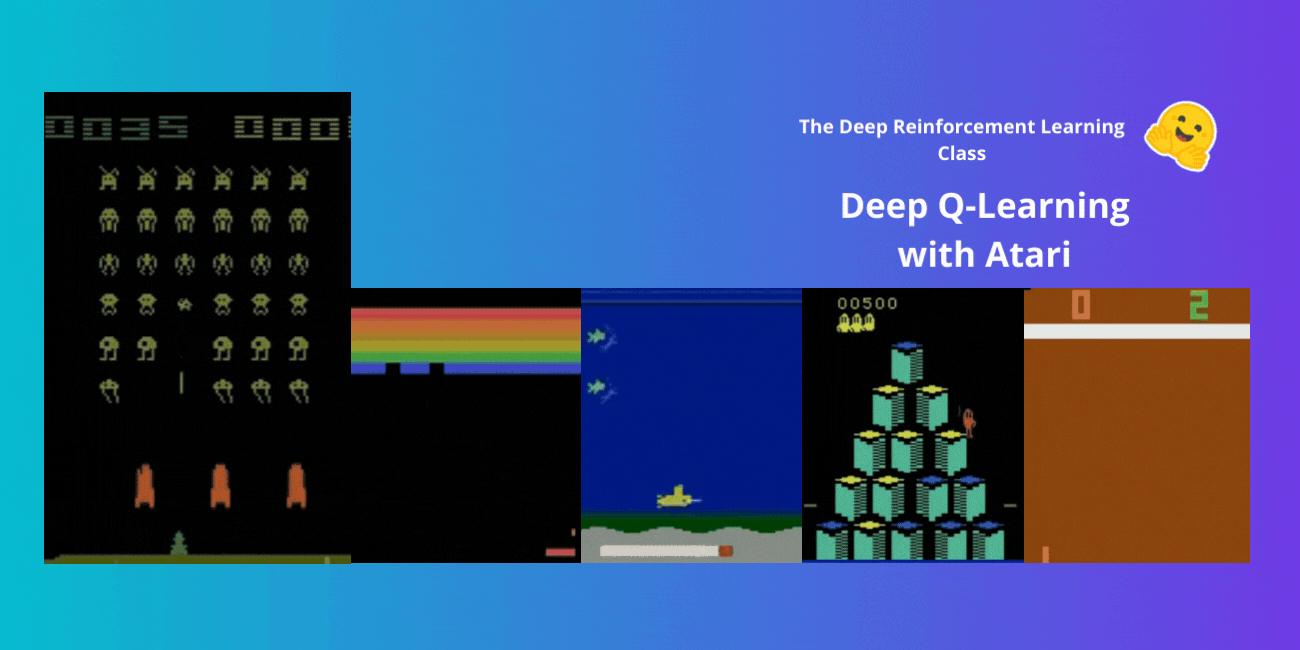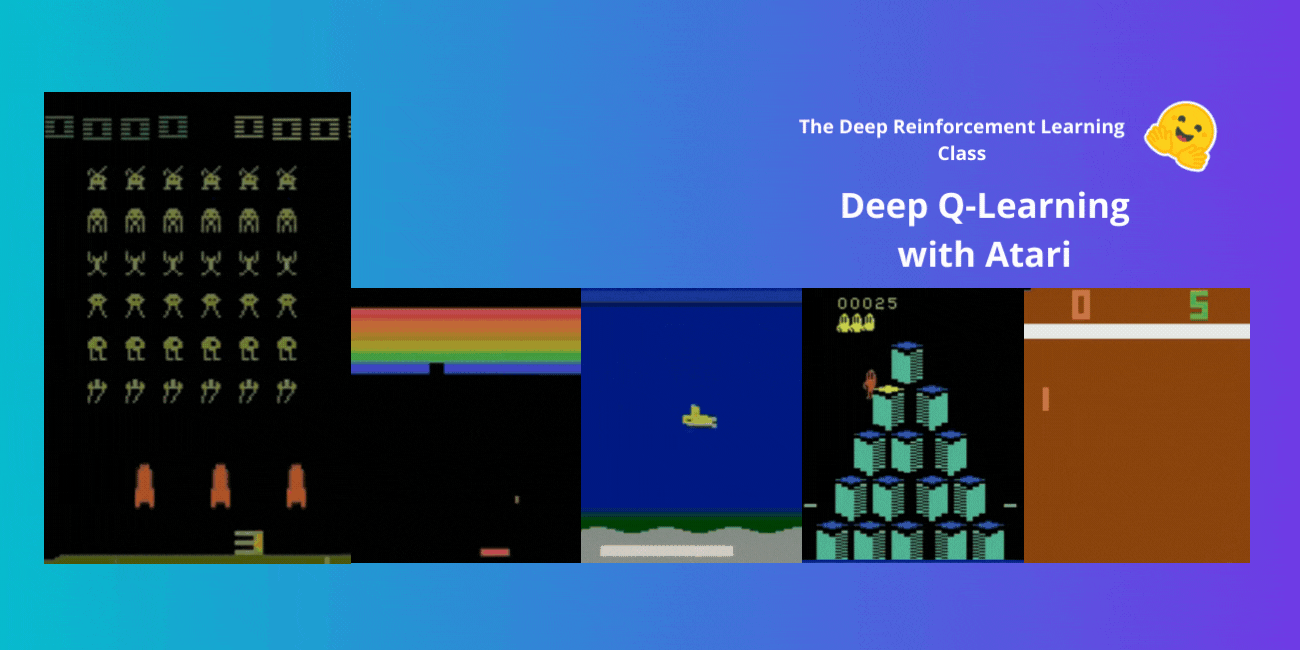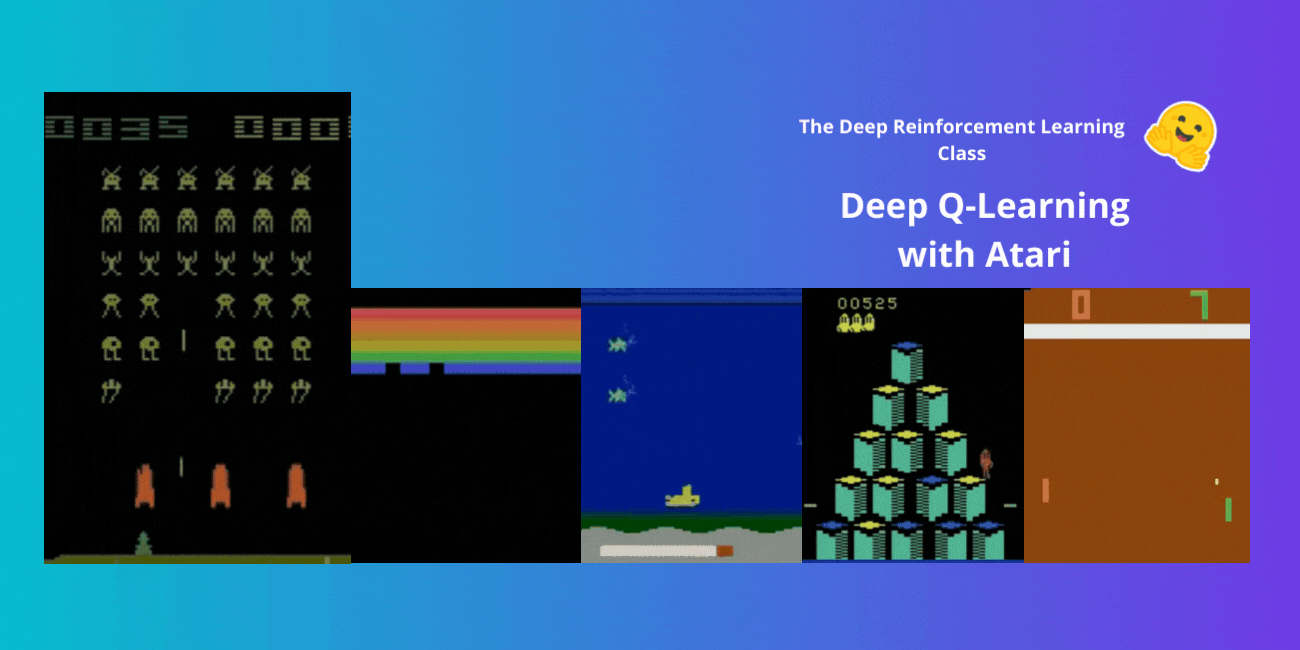
ღრმა Q-სწავლება: როგორ ვავარჯიშოთ აგენტები Atari-ს თამაშებში
ეს სტატია ღრმა გაძლიერებული სწავლების კურსის ნაწილია. განვიხილავთ, თუ როგორ გადადის ტრადიციული Q-სწავლება, რომელსაც შეზღუდვები აქვს დიდი მდგომარეობათა სივრცეების შემთხვევაში, ღრმა Q-სწავლებაში. ეს უკანასკნელი იყენებს ნერვულ ქსელებს Q-მნიშვნელობების აპროქსიმაციისთვის, რაც საშუალებას გვაძლევს მოვამზადოთ აგენტები რთული გარემოებისთვის, როგორიცაა Atari-ს თამაშები. სტატია დეტალურად აღწერს Deep Q-Network-ის არქიტექტურას, მონაცემთა წინასწარ დამუშავებას და ჩარჩოების დაწყობის მნიშვნელობას დროითი შეზღუდვებ

ხელოვნური ინტელექტის მიერ გენერირებული კონტენტის წყლის ნიშნები და მისი ავთენტურობის დაცვა
ამ ბლოგპოსტში განვიხილავთ ხელოვნური ინტელექტის (AI) მიერ გენერირებული კონტენტის წყლის ნიშნების დამატების მეთოდებს, მათ უპირატესობებსა და ნაკლოვანებებს, ასევე Hugging Face Hub-ზე არსებულ ინსტრუმენტებს. სტატია ასევე აანალიზებს კონტენტის ავთენტურობის დაცვის სხვა ტექნიკებს, როგორიცაა გამოსახულების ცვლილება და „მოწამვლა“, და მიმოიხილავს ღია და დახურული სისტემების გამოწვევებს სხვადასხვა მოდიფიკაციისთვის.

Hugging Face-ის Kernel Hub: ხელოვნური ინტელექტის მოდელების მუშაობის დაჩქარება ოპტიმიზებული ბირთვებით
Hugging Face-ის ახალი Kernel Hub რევოლუციას ახდენს მანქანური სწავლების მოდელების ოპტიმიზაციაში. ის უზრუნველყოფს ცენტრალიზებულ საცავს წინასწარ კომპილირებული, მაღალეფექტური გამოთვლითი ბირთვებისთვის, რაც დეველოპერებს საშუალებას აძლევს, მარტივად ჩართონ ოპტიმიზებული კოდი სწრაფი ოპერაციებისთვის, განსაკუთრებით GPU-ებზე, რთული კომპილაციის პროცესების გარეშე. ეს დრამატულად ამარტივებს მაღალი წარმადობის მიღწევას ML პროექტებში, რაც დეველოპერებს საშუალებას აძლევს, მეტი დრო დაუთმონ მოდელების აგებას და ნაკლები
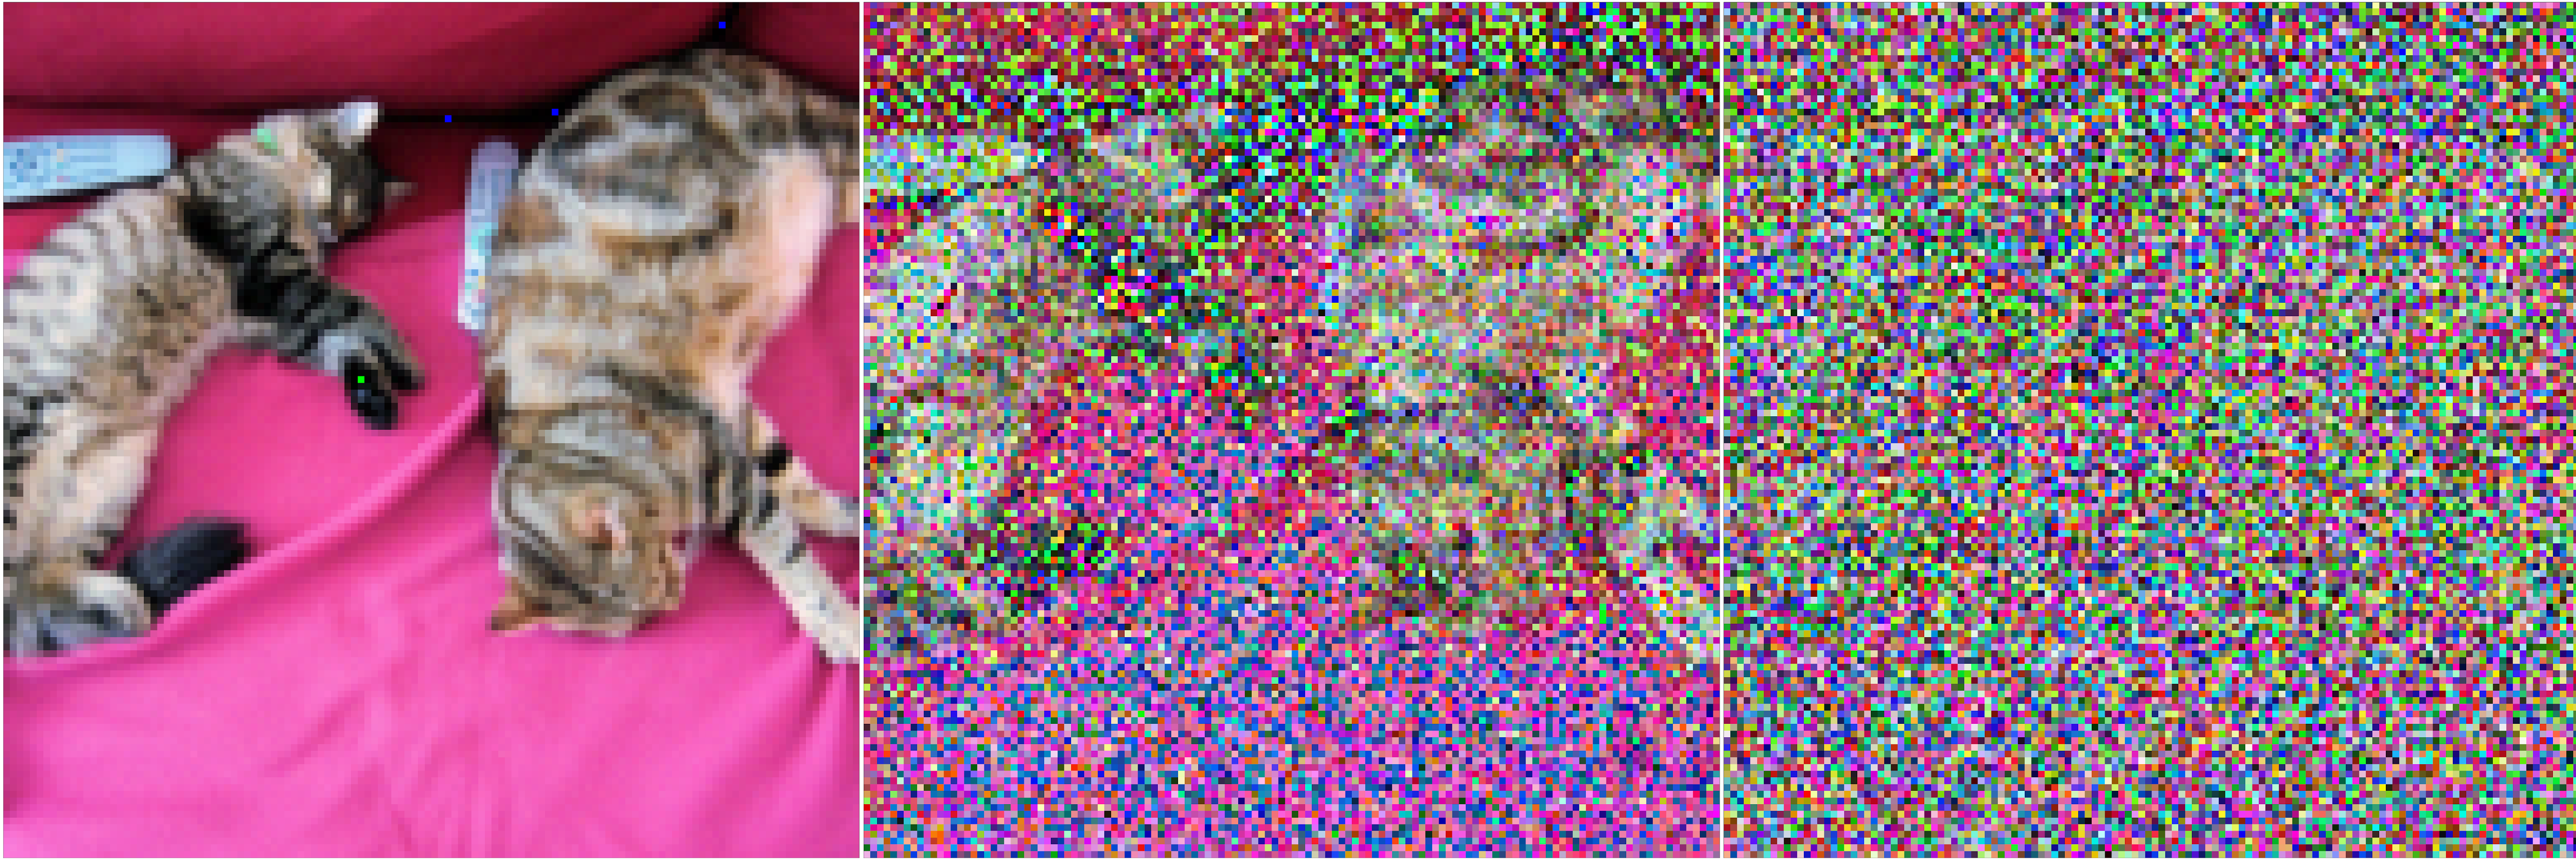
დენოიზინგ დიფუზიური ალბათური მოდელები (DDPM): კონცეფციიდან იმპლემენტაციამდე PyTorch-ში
ეს სტატია განიხილავს Ho et al.-ის (2020) ორიგინალური ნაშრომის მიხედვით დენოიზინგ დიფუზიურ ალბათურ მოდელებს (DDPM) და მათ ნაბიჯ-ნაბიჯ იმპლემენტაციას PyTorch-ში. იგი აშუქებს დიფუზიური მოდელების ისტორიულ კონტექსტს, მათ მათემატიკურ საფუძვლებს და ხსნის როგორც პირდაპირ, ასევე შებრუნებულ პროცესებს, რომლებიც საშუალებას აძლევს ნერვულ ქსელს გარდაქმნას ხმაურიანი მონაცემები რეალურ ნიმუშებად.
TTS Arena: მეტყველების სინთეზის მოდელების შეფასების დემოკრატიზაცია
მეტყველების სინთეზის სფეროში დიდი ხანია არ არსებობდა მოდელების ხარისხის ზუსტი გაზომვის მეთოდი. არსებული ობიექტური და სუბიექტური მეთოდები არაეფექტურია მსგავსი ხარისხის მოდელების შესადარებლად. ამ გამოწვევის საპასუხოდ, შეიქმნა TTS Arena, სადაც საზოგადოებას შეუძლია შეაფასოს სინთეზირებული აუდიო და დაეხმაროს მოდელების რანჟირების დემოკრატიზაციას. პლატფორმა იყენებს ადამიანის შეფასებას, მსგავსად Chatbot Arena-ისა, მოდელების ობიექტური შედარებისთვის.

vLLM-ის ოპტიმიზაცია: პრეფილის სტრატეგიები და გრძელი მოთხოვნების მართვა
სტანდარტულად, vLLM-ში პრეფილის ფაზა თანმიმდევრულად ამუშავებს მოთხოვნებს, რაც პრობლემური ხდება გრძელი "პრომპტების" შემთხვევაში, რადგან მათ შეუძლიათ შეაფერხონ შემდგომი მოთხოვნები და გაზარდონ შეყოვნება. მიუხედავად იმისა, რომ პარალელური პრეფილის მცდელობები არსებობდა, ისინი რესურსების ოპტიმიზაციის პრობლემებს აწყდებოდნენ. vLLM-ის უახლესმა განახლებამ წარმოადგინა გაუმჯობესებული სტრატეგია, რომელიც იძლევა მოკლე მოთხოვნების პარალელური პრეფილის საშუალებას გრძელი მოთხოვნების შეფერხების გარეშე, რაც მნიშვნელოვ
vLLM-ის ოპტიმიზაცია: პრეფილისა და დეკოდირების გამოწვევების დაძლევა
ეს სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაციის გამოწვევებს vLLM-ში, განსაკუთრებით "პრეფილის" ფაზაში, სადაც გრძელ პრომპტებს შეუძლიათ შეაფერხონ მომდევნო მოთხოვნები. იგი აღწერს გაუმჯობესებულ სტრატეგიას, რომელიც იძლევა მოკლე მოთხოვნების პარალელური პრეფილის საშუალებას, ხოლო გრძელი მოთხოვნებისთვის თანმიმდევრულ დამუშავებას ინარჩუნებს. ასევე წარმოდგენილია "დეზაგრეგირებული პრეფილი" – უფრო რადიკალური გადაწყვეტა ტოკენის გენერაციის შენელების აღმოსაფხვრელად, თუმცა რესურსების უფრო