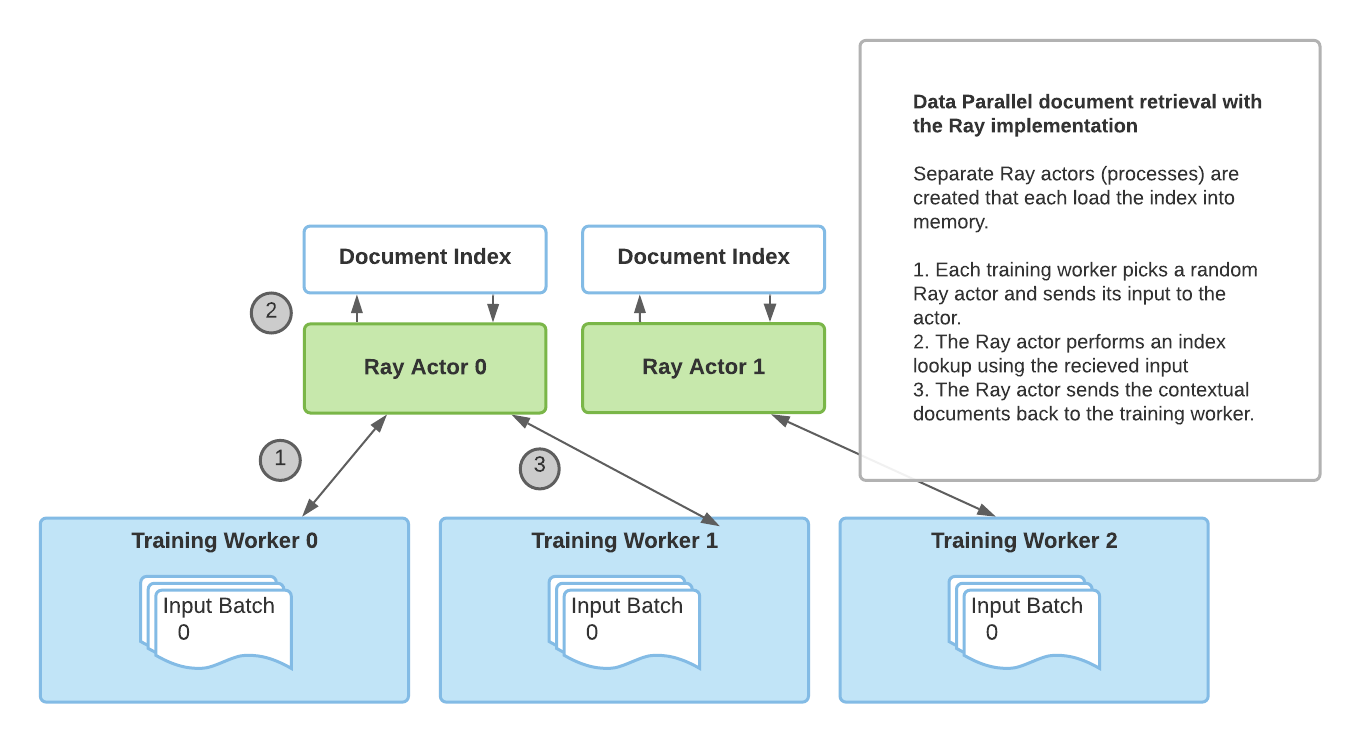
RAG მოდელების გაძლიერება Ray-ის საშუალებით: განაწილებული ინფორმაციის მოძიების სიჩქარის გაორმაგება
სტატია განიხილავს RAG (Retrieval Augmented Generation) მოდელების მუშაობის პრინციპებს, რომლებიც კონტექსტური დოკუმენტების მოძიებით აუმჯობესებენ გენერაციის ხარისხს. წარმოდგენილია წინა იმპლემენტაციის (torch.distributed) შეზღუდვები და შემოთავაზებულია ახალი, გაუმჯობესებული მიდგომა Ray ბიბლიოთეკის გამოყენებით. Ray-ზე დაფუძნებული განაწილებული მოძიების იმპლემენტაცია არა მხოლოდ 2-ჯერ ზრდის მოძიების სიჩქარეს, არამედ აუმჯობესებს მოდელების დაზუსტებული კონფიგურაციის (fine-tuning) მასშტაბირებადობას და ხსნის Py
DeepFloyd IF-ის ინტეგრაცია BentoML-თან პროდუქტიული განთავსებისთვის
სტატია მიმოიხილავს, თუ როგორ ხდება BentoML-ის, ღია კოდის პლატფორმის, გამოყენება DeepFloyd IF-ის, თანამედროვე ტექსტიდან გამოსახულების გენერირების მოდელის, განთავსებისთვის. აღწერილია DeepFloyd IF-ის უნიკალური არქიტექტურა (პიქსელურ სივრცეში მუშაობა, კასკადური დიფუზია, LLM-ის გამოყენება მოთხოვნებისთვის) და BentoML-ის მეშვეობით რესურსების ოპტიმალური მართვა, მათ შორის GPU-ს განაწილება. მოცემულია ინსტრუქციები პროექტის ლოკალურად გაშვებისთვის, მოდელების ჩამოტვირთვისთვის, სერვერის Gradio-სთან ერთად გაშვებ

DeepSeek R1-ის გამოშვებიდან ორი კვირა: ღია-R1 პროექტის მიღწევები და გამოწვევები
სტატია აჯამებს ღია-R1 პროექტის განვითარებას, რომელიც DeepSeek R1-ის სასწავლო კონვეიერისა და სინთეზური მონაცემების რეპლიკაციას ისახავს მიზნად. მიღწევებს შორისაა DeepSeek-ის შეფასების ქულების რეპროდუცირება და GRPO-ის ინტეგრაცია TRL-ში. პროექტი DeepSeek R1-ის ხანგრძლივი პასუხების გამო GPU მეხსიერებისა და გენერაციის ეფექტურობის გამოწვევების წინაშე დგას, თუმცა ინფერენსის ოპტიმიზაციაში მნიშვნელოვანი პროგრესია. ინიციატივამ მედიის ფართო ინტერესიც გამოიწვია.
ნერვული ქსელების აგება და გამართვა: ჰაიპის მიღმა
სტატია მიმოიხილავს ნერვული ქსელების, მათ შორის GPT-3-ის, ირგვლივ არსებულ დიდ აჟიოტაჟს და უპირისპირებს მას ამ ტექნოლოგიების რეალურ შექმნასა და გამართვასთან დაკავშირებულ სირთულეებს. ავტორი გვთავაზობს პრაქტიკულ, სისტემატურ მიდგომას ნერვული ქსელების დიზაინისა და დებაგინგისთვის, ხაზს უსვამს მონაცემთა სიღრმისეული ანალიზის, მარტივი ბაზისური მოდელების გამოყენებისა და დეტალური ტესტირების მნიშვნელობას, განსაკუთრებით Hugging Face-ში მუშაობის გამოცდილებიდან გამომდინარე.
Bark TTS მოდელის ოპტიმიზაცია Hugging Face ეკოსისტემით: მეხსიერება და ინფერენსის გაუმჯობესება
ეს სტატია წარმოგიდგენთ 'Bark' ტექსტიდან მეტყველებად გარდამქმნელი (TTS) მოდელის ოპტიმიზაციის პრაქტიკულ სახელმძღვანელოს Hugging Face-ის 'Transformers', 'Optimum' და 'Accelerate' ბიბლიოთეკების გამოყენებით. დეტალურად განიხილება მეხსიერების მოხმარების შემცირებისა და ინფერენსის სიჩქარის გაუმჯობესების სამი მარტივი მეთოდი, მათ შორის 'Better Transformer' და 'Flash Attention'. ასევე ნაჩვენებია ოპტიმიზებული და არაოპტიმიზებული მოდელების წარმადობის შედარებისა და ბენჩმარკინგის პროცესი.

Adyen-ისა და Hugging Face-ის DABstep: ხელოვნური ინტელექტის მოდელების გამოწვევა მონაცემთა ანალიზში
Adyen-მა და Hugging Face-მა ერთობლივად შექმნეს DABstep – ახალი ბენჩმარკი, რომელიც 450-ზე მეტ მონაცემთა ანალიზის ამოცანას მოიცავს. მისი მიზანია ხელოვნური ინტელექტის (AI) უახლესი მოდელების შესაძლებლობების შეფასება მრავალსაფეხურიან აზროვნებაში. კვლევამ აჩვენა, რომ მიუხედავად განვითარებისა, AI აგენტები DABstep-ზე მხოლოდ 16%-იან სიზუსტეს აღწევენ, რაც მიუთითებს ამ სფეროში მნიშვნელოვანი პროგრესის საჭიროებაზე. ბენჩმარკი მოითხოვს, რომ AI მოდელებმა გამოავლინონ ტექნიკური უნარები, დომენური ცოდნა და კრეატიულ
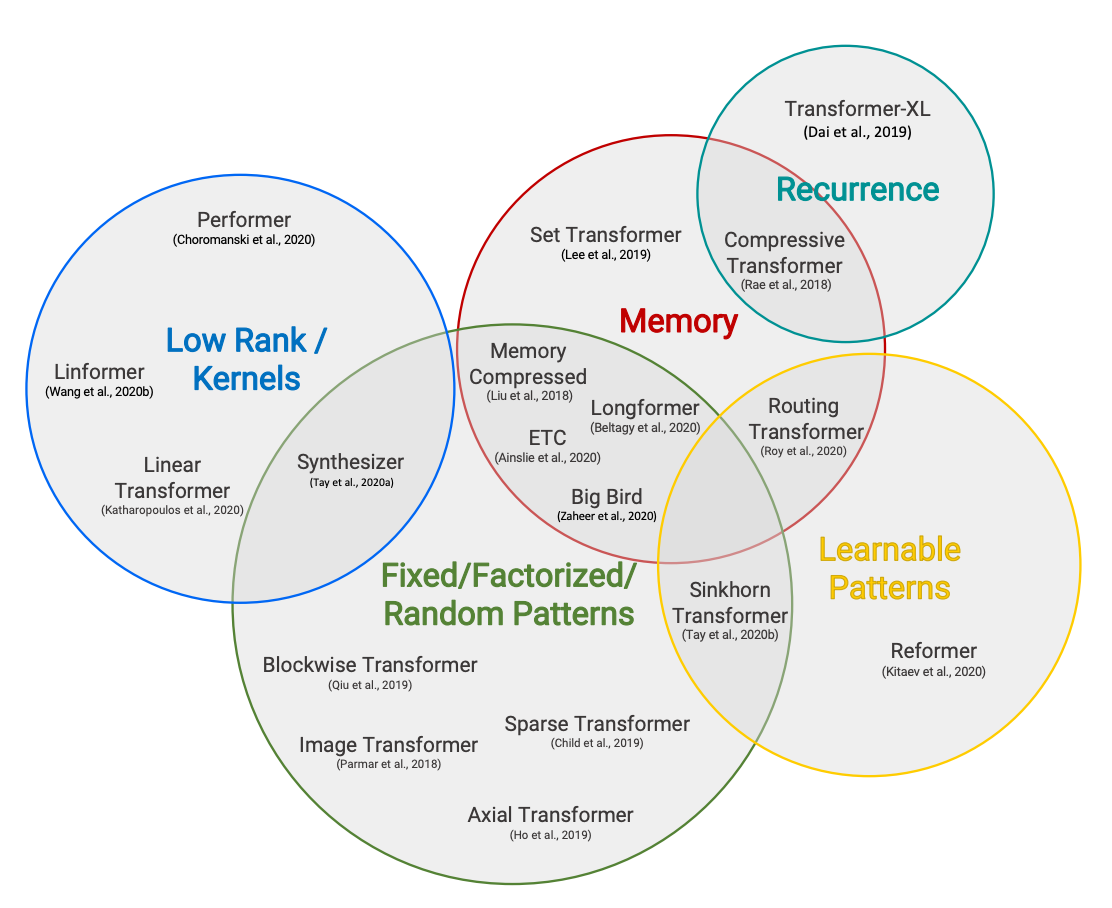
ტრანსფორმერების ეფექტურობის გამოწვევები: შორს მიმავალი ყურადღება და მეხსიერების ოპტიმიზაცია
დიდი ტრანსფორმერების მოდელების გამოთვლითი მოთხოვნების შემცირება კვლევის ერთ-ერთი მთავარი მიმართულებაა, განსაკუთრებით თანმიმდევრობის სიგრძესთან დაკავშირებული კვადრატული დანახარჯის პრობლემის გამო. სტატია განიხილავს ოთხ ძირითად მიდგომას ამ გამოწვევის მოსაგვარებლად: Longformer, Transformer-XL, Compressive Transformer და დაბალი რანგის ყურადღების მატრიცების გამოყენება, რომლებიც მიზნად ისახავს მოდელების მეხსიერებისა და დროის ეფექტურობის გაუმჯობესებას გრძელი თანმიმდევრობების დამუშავებისას.
Hugging Face AWS Marketplace-ზე: AI-ის დანერგვის გამარტივება ბიზნესისთვის
Hugging Face-ის AWS Marketplace-ზე ინტეგრაცია აადვილებს კომპანიებისთვის დიდი ენობრივი მოდელების გამოყენებას და ხელოვნური ინტელექტის (AI) დანერგვას. AWS-ის მომხმარებლებს ახლა შეუძლიათ მარტივად გამოიწერონ Hugging Face სერვისები, ხოლო გადახდები ავტომატურად აისახება მათ AWS გადასახადში. ეს ინიციატივა არა მხოლოდ ამარტივებს პროცესს, არამედ სთავაზობს დამატებით უსაფრთხოების ფუნქციებს Enterprise Hub-ის მეშვეობით, რაც ტექნოლოგიას უფრო მეტ დეველოპერსა და ბიზნესს მიაწვდის.

Physical Intelligence-ი წარმოგიდგენთ π0-ს და π0-FAST-ს: რობოტების მრავალმხრივი კონტროლისთვის
კომპანია Physical Intelligence-მა შექმნა π0 და π0-FAST – პროტოტიპული გენერალისტი რობოტ მოდელები, რომლებიც მიზნად ისახავს ხელოვნურ ინტელექტსა და ფიზიკურ სამყაროს შორის არსებული უფსკრულის ამოვსებას. ეს ხედვა-ენა-მოქმედების (VLA) მოდელები, რომლებიც გაწვრთნილია მრავალფეროვან რობოტულ მონაცემებზე, გამოირჩევიან მრავალმხრივი კონტროლით სხვადასხვა ამოცანასა და რობოტის ტიპებზე, ნაკადის შესაბამისობის (flow matching) მეთოდის გამოყენებით ეფექტური, რეალურ დროში მოქმედების გენერაციისთვის. ისინი სძლევენ ტრადიციუ
ფიზიკური ინტელექტის ინოვაცია: რობოტების გენერალისტი კონტროლის მოდელები π0 და π0-FAST
Physical Intelligence-მა წარმოადგინა π0 და π0-FAST, პროტოტიპული მოდელები და სასწავლო ფრეიმვორკები, რომლებიც შექმნილია რობოტების გენერალისტური კონტროლისთვის. ისინი მიზნად ისახავს ხიდის გადებას ხელოვნური ინტელექტის სისტემებსა და ფიზიკურ სამყაროს შორის არსებულ ხარვეზებს შორის, LLM-ებისა და VLM-ებისგან განსხვავებით, რომელთაც ფიზიკურ სამყაროსთან ურთიერთქმედება აკლიათ. π0, ხედვით-ენობრივ-მოქმედებითი (VLA) მოდელი, გაწვრთნილია 7 რობოტული პლატფორმისა და 68 უნიკალური ამოცანის მონაცემებზე, რაც მას საშუალებ
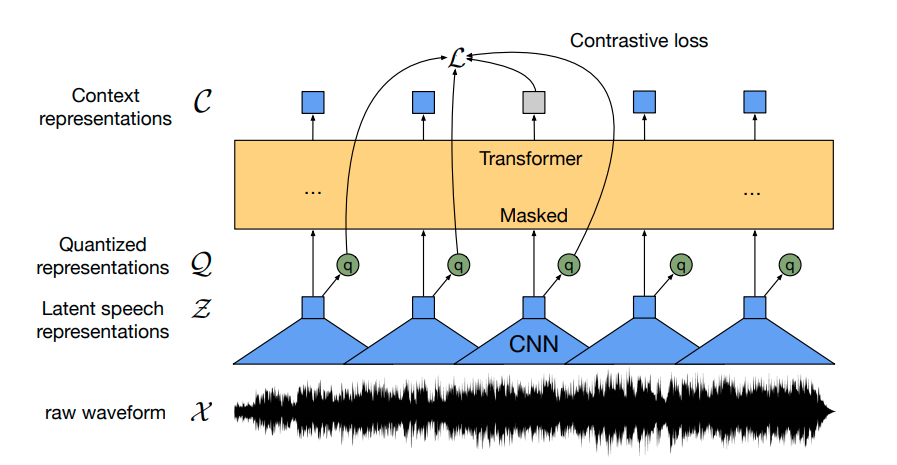
Wav2Vec2: ახალი ეპოქა მეტყველების ავტომატურ ამოცნობაში
Wav2Vec2 წარმოადგენს ინოვაციურ მოდელს, რომელიც იყენებს კონტრასტულ წინასწარ წვრთნას 50 000 საათზე მეტი არადანიშნული მეტყველების მონაცემებიდან მძლავრი წარმოდგენების შესასწავლად. BERT-ის მსგავსად, ის ნიღბავს ფუნქციის ვექტორებს კონტექსტუალიზებული წარმოდგენების მისაღებად. მოდელმა აჩვენა კონკურენტული შედეგები თანამედროვე ავტომატური მეტყველების ამოცნობის (ASR) სისტემებთან, მინიმალური, სულ რაღაც 10 წუთის, დანიშნულ მონაცემებზე დამატებითი წვრთნის შემდეგ. ეს სტატია დეტალურად განმარტავს Wav2Vec2-ის წინასწარ
Wav2Vec2: გარღვევა მეტყველების ამოცნობაში მინიმალური მარკირებული მონაცემებით
Wav2Vec2, რევოლუციური ხელოვნური ინტელექტის მოდელი, სწავლობს მეტყველების მძლავრ წარმოდგენებს დიდი მოცულობის არამარკირებული აუდიო მონაცემებიდან, კონტრასტული წინასწარი ვარჯიშის ინოვაციური მეთოდის გამოყენებით. მან აჩვენა უპრეცედენტო შედეგები ავტომატური მეტყველების ამოცნობის (ASR) სფეროში, მიაღწია უმაღლეს დონეს მაშინაც კი, როდესაც დამატებითი ვარჯიში (fine-tuning) ხდება სულ რაღაც 10 წუთის მარკირებულ მეტყველების მონაცემებზე. ეს მას ქმნის მაღალეფექტურ გადაწყვეტილებად ძლიერი ASR სისტემების შესაქმნელად, რ
IDEFICS: ღია მულტიმოდალური AI მოდელი გამჭვირვალე კვლევისთვის
IDEFICS, 80 მილიარდი პარამეტრის მულტიმოდალური ხელოვნური ინტელექტის (AI) მოდელი, რომელიც Flamingo-ს ღია წყაროს რეპროდუქციას წარმოადგენს, უკვე ხელმისაწვდომია. მისი შექმნისას დიდი აქცენტი გაკეთდა გამჭვირვალობაზე, გამოყენებულ იქნა მხოლოდ საჯაროდ ხელმისაწვდომი მონაცემები და შეფასდა პოტენციური მიკერძოებები. მოდელი მიზნად ისახავს მულტიმოდალური AI სისტემების სფეროში უფრო ღია კვლევების წახალისებას და მისი დემო ვერსიები Hugging Face Hub-ზეა განთავსებული.
OpenAI-მ Deep Research გამოუშვა: ვებ-დათვალიერების სისტემა და ღია კოდით მისი რეპროდუცირების მცდელობები
OpenAI-მ წარმოადგინა „Deep Research“ – ინოვაციური სისტემა, რომელიც ვებ-კონტენტს აჯამებს და კითხვებზე პასუხობს. სისტემამ შთამბეჭდავი შედეგები აჩვენა General AI Assistants (GAIA) ბენჩმარკზე, მიაღწია თითქმის 67%-იან სიზუსტეს საშუალოდ და 47.6%-ს რთულ „დონე 3“ კითხვებზე. Deep Research აგებულია დიდ ენობრივ მოდელზე (LLM) და აგენტურ ჩარჩოზე, რომელიც მას ინსტრუმენტების გამოყენებაში ეხმარება. მიუხედავად OpenAI-ს მიერ აგენტური ჩარჩოს დეტალების არგამჟღავნებისა, ღია კოდის საზოგადოებამ 24-საათიანი მისია დაიწყ
მომხმარებელთა შეფასებების სენტიმენტური ანალიზის მიკროსერვისის შექმნა Google Cloud-ზე
სტატია აღწერს მიკროსერვისის შექმნის პროცესს, რომელიც Discord-ში დატოვებულ მომხმარებელთა შეფასებებს ავტომატურად აანალიზებს და მათ პოზიტიურ ან ნეგატიურ შინაარსს განსაზღვრავს. ავტორი განიხილავს საწყის სირთულეებს მოდელის ჩატვირთვისა (როგორიცაა .h5 ფაილის ტიპის გაგება) და შესაბამისი ღრუბლოვანი პლატფორმის შერჩევისას (AI-Platform Prediction, App Engine, Cloud Run). საბოლოოდ, წარმოადგენს Cloud Run-სა და PyTorch-ზე დაფუძნებულ, Docker-ის გამოყენებით განხორციელებულ გადაწყვეტას, რომელიც ოპტიმიზირებულია მეხს
Hugging Face წარმოგიდგენთ SafeCoder-ს: უსაფრთხო, თვით-ჰოსტინგით AI პროგრამისტს საწარმოებისთვის
Hugging Face-ის SafeCoder მიზნად ისახავს პროგრამული უზრუნველყოფის შემუშავების პროდუქტიულობის გაზრდას საწარმოებში, სრულად შესაბამისი, თვით-ჰოსტინგითა და უსაფრთხო AI კოდის ასისტენტის შეთავაზებით. გადაწყვეტა ეფუძნება ღია კოდის მოდელებს, როგორიცაა StarCoder, და უზრუნველყოფს მონაცემთა კონფიდენციალურობასა და იურიდიულ შესაბამისობას, რადგან კომპანიებს საშუალებას აძლევს, საკუთარ ინფრასტრუქტურაზე დაახვეწონ LLM-ები, მესამე მხარესთან კოდის გაზიარების გარეშე.

არაბული LLM ლიდერბორდების აღზევება: გამოწვევები და ინოვაციები
არაბულენოვანი დიდი ენობრივი მოდელების (LLM) მზარდი ხელმისაწვდომობის ფონზე, 2024 წელს დაიწყო რამდენიმე სპეციალიზებული ლიდერბორდის გაშვება, რომლებმაც მნიშვნელოვნად გააუმჯობესეს არაბული ხელოვნური ინტელექტის მოდელების შეფასება. ამ ინიციატივებმა, მათ შორის Open Arabic LLM Leaderboard (OALL), Balsam Index-მა და AraGen Leaderboard-მა, გადაჭრა არსებული გამოწვევები და სწრაფად მოიპოვა პოპულარობა, გახდა რა ცენტრალური პლატფორმები არაბული AI საზოგადოებისთვის. მათ ხაზი გაუსვეს არაბული ენის უნიკალური სირთულეებ
Hugging Face-ისა და Amazon-ის სტრატეგიული პარტნიორობა: უახლესი ML მოდელების გამოყენების გამარტივება SageMaker-ში
Hugging Face-მა და Amazon-მა სტრატეგიული პარტნიორობა გამოაცხადეს, რათა კომპანიებისთვის უახლესი მანქანური სწავლების (ML) მოდელების გამოყენება და NLP ფუნქციების სწრაფად დანერგვა გაამარტივონ. Hugging Face Amazon Web Services-ს (AWS) სასურველ ღრუბლოვან პროვაიდერად ირჩევს. ამ თანამშრომლობის პირველი ნაბიჯი Hugging Face-ის ახალი ღრმა სწავლების კონტეინერების (DLCs) შეთავაზებაა, რაც Amazon SageMaker-ში Transformer მოდელების გაწვრთნას უპრეცედენტოდ ამარტივებს.
Hugging Face და Amazon სტრატეგიულ პარტნიორობას აცხადებენ ხელოვნური ინტელექტისა და NLP განვითარების დასაჩქარებლად
Hugging Face-მა და Amazon-მა სტრატეგიული პარტნიორობის შესახებ განაცხადეს, რომლის მიზანია კომპანიებისთვის უახლესი მანქანური სწავლის მოდელების გამოყენების გამარტივება და მოწინავე ბუნებრივი ენის დამუშავების (NLP) ფუნქციების უფრო სწრაფად მიწოდება. პარტნიორობის ფარგლებში, Hugging Face იყენებს Amazon Web Services-ს (AWS) როგორც სასურველ ღრუბლოვან პროვაიდერს. თანამშრომლობის პირველი ნაბიჯი არის Hugging Face-ის ახალი ღრმა სწავლის კონტეინერების (DLCs) წარდგენა, რაც მნიშვნელოვნად გაამარტივებს Transformer მ
Hugging Face-მა AutoGPTQ ინტეგრირება მოახდინა Transformers-ში: ხელმისაწვდომი დიდი ენობრივი მოდელები
Hugging Face-მა თავის Transformers ბიბლიოთეკაში AutoGPTQ-ის ინტეგრირებით, დიდი მანქანური სწავლის მოდელების ხელმისაწვდომობა მნიშვნელოვნად გაზარდა. ეს მომხმარებლებს საშუალებას აძლევს, მოდელების 8-დან 2-ბიტამდე სიზუსტით კვანტიზაცია და გაშვება შეძლონ GPTQ ალგორითმის გამოყენებით, მინიმალური სიზუსტის დაკარგვით და გაუმჯობესებული წარმადობით. ინტეგრაცია ხელმისაწვდომია როგორც Nvidia, ასევე RoCm-ზე მომუშავე AMD GPU-ებისთვის, რაც LLM-ების ოპტიმიზაციას უფრო ფართო აუდიტორიისთვის ხდის შესაძლებელს.

Open R1 პროექტი წარმოგიდგენთ OpenR1-Math-220k: მათემატიკური მსჯელობის ახალ, მასშტაბურ მონაცემთა ნაკრებს
Open R1 პროექტი, რომლის მიზანია DeepSeek R1-ის ტრენინგის პროცესებისა და სინთეზური მონაცემების აღდგენა, სიამოვნებით აცხადებს OpenR1-Math-220k-ის შექმნას – მათემატიკური მსჯელობისთვის განკუთვნილი პირველი ფართომასშტაბიანი მონაცემთა ნაკრები. ეს პოსტი დეტალურად აღწერს მის შექმნის პროცესს, მათ შორის 512 H100 გრაფიკული პროცესორის გამოყენებას გენერაციისთვის და ხარისხის უზრუნველსაყოფად წესებზე დაფუძნებული (Math Verify) და დიდი ენობრივი მოდელებზე დაფუძნებული (Llama-3.3-70B-Instruct) ვალიდაციის მეთოდების კო
Open R1 პროექტი: OpenR1-Math-220k მონაცემთა ნაკრების წარდგენა მათემატიკური მსჯელობისთვის
Open R1 პროექტი, რომლის მიზანია DeepSeek R1-ის დაკარგული კომპონენტების – კერძოდ, საწვრთნელი პაიპლაინისა და სინთეზური მონაცემების – რეკონსტრუქცია, უკვე ორი კვირაა მიმდინარეობს. ამ პოსტში წარმოდგენილია OpenR1-Math-220k: ჩვენი პირველი ფართომასშტაბიანი მონაცემთა ნაკრები მათემატიკური მსჯელობისთვის. განხილულია საზოგადოების ძალისხმევა მცირე, მაღალი ხარისხის მონაცემთა ნაკრებების შესაქმნელად და მსჯელობის მოდელებიდან „აზროვნების ჯაჭვის“ (chain-of-thought) სიგრძის კონტროლის მეთოდები. სტატია დეტალურად აღწერ
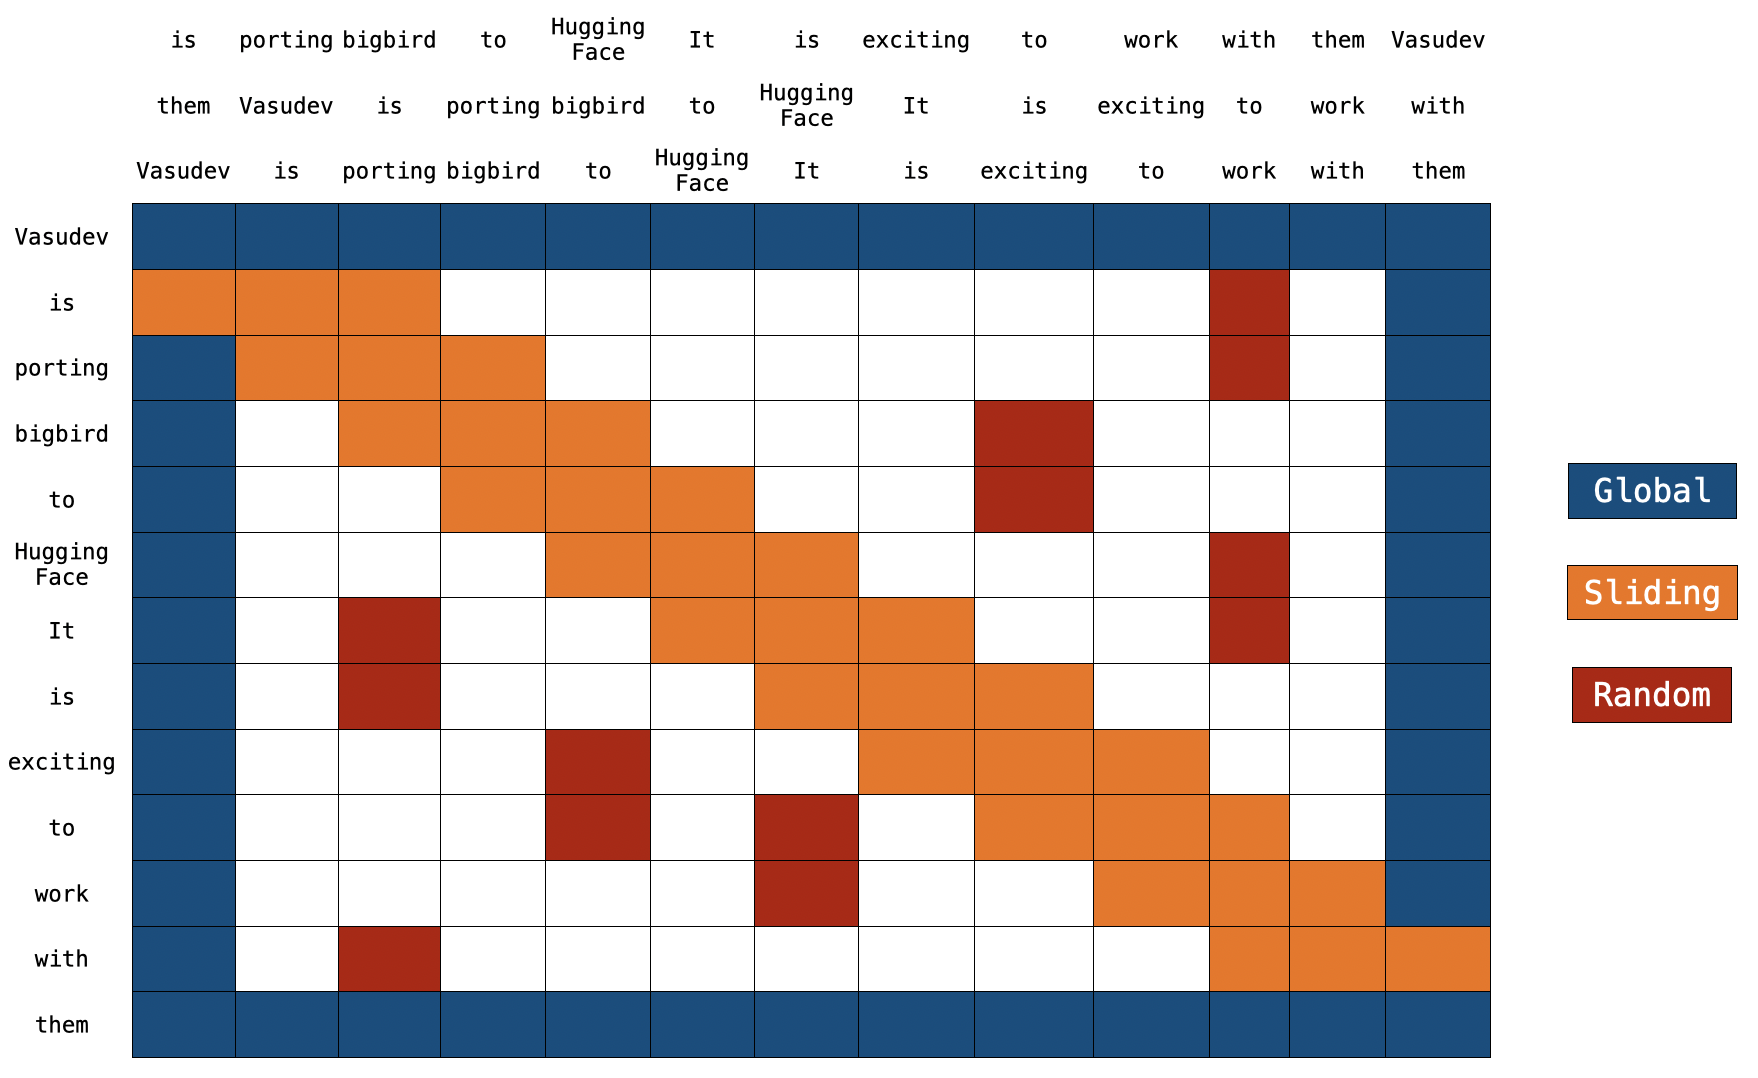
BigBird: ტრანსფორმატორების ახალი ეფექტური მიდგომა გრძელი თანმიმდევრობებისთვის
ტრანსფორმატორული მოდელები ფართოდ გამოიყენება NLP ამოცანებში, თუმცა მათი O(n^2) დროითი და მეხსიერების სირთულე ზღუდავს მათ გამოყენებას გრძელ თანმიმდევრობებზე (n > 512). BigBird, ახალი მოდელი, ამ პრობლემას ბლოკ-სპარსული ყურადღების (block sparse attention) გამოყენებით აგვარებს, რაც საშუალებას აძლევს მას დაამუშაოს თანმიმდევრობები 4096 სიგრძემდე, მნიშვნელოვნად დაბალი გამოთვლითი დანახარჯით, ვიდრე BERT. BigBird-მა მიაღწია საუკეთესო შედეგებს (SOTA) გრძელ დოკუმენტებთან დაკავშირებულ ამოცანებში, როგორიცაა შ
უსაფრთხოების გაუმჯობესება: Git ავტორიზაცია Hugging Face-ზე გადადის ტოკენებსა და SSH კლავიშებზე
Hugging Face-ის მომხმარებლებმა Git ოპერაციებისთვის პაროლის ნაცვლად უნდა გამოიყენონ პირადი წვდომის ტოკენები ან SSH კლავიშები 2023 წლის 1 ოქტომბრამდე. ეს ცვლილება მიზნად ისახავს პლატფორმის უსაფრთხოების მნიშვნელოვნად გაუმჯობესებას.